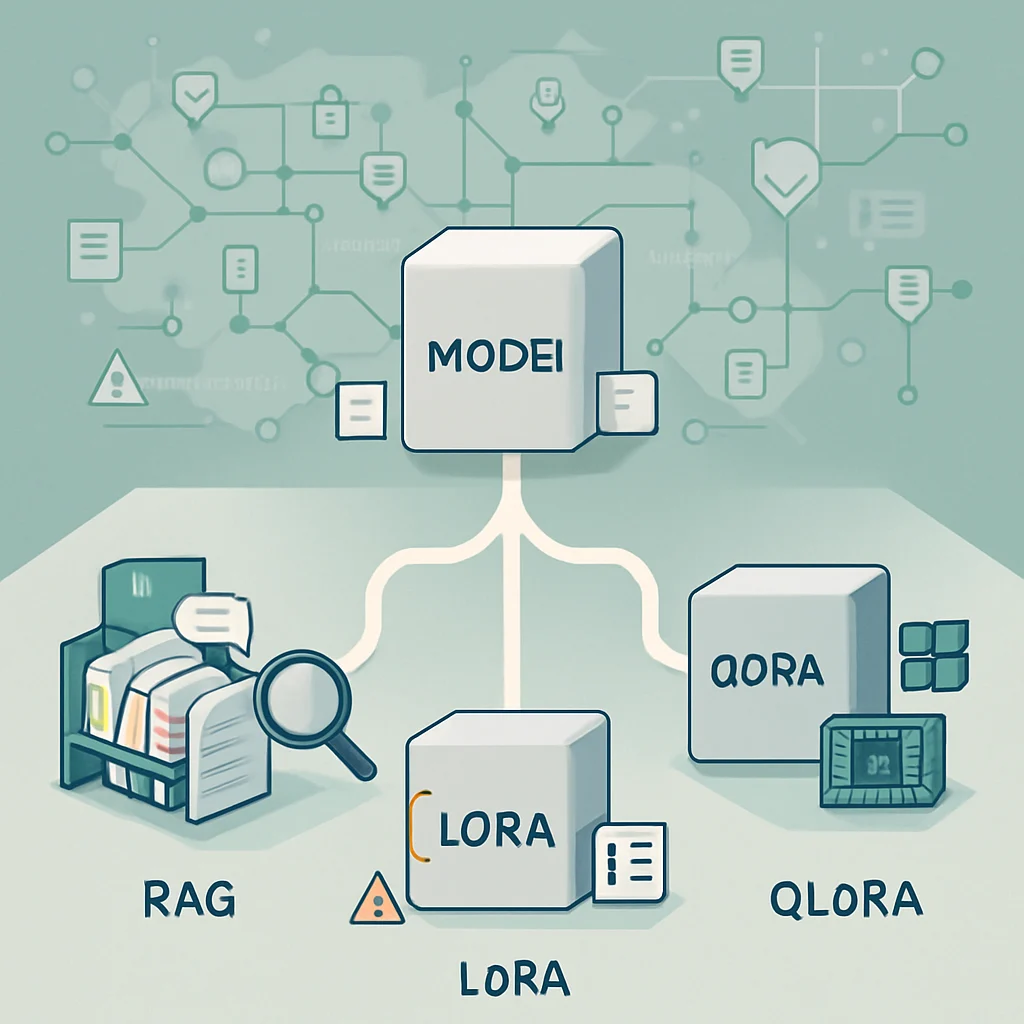
Table des matières :
- Clarifier le cas d’usage avant de parler de fine-tuning LLM
- RAG : relier un LLM à vos documents, sans l’entraîner
- LoRA : un fine-tuning frugal pour spécialiser un LLM
- QLoRA : pousser l’adaptation plus loin avec la quantification 4 bits
- Choisir RAG, LoRA ou QLoRA selon l’usage : une matrice décisionnelle
- Données sensibles, conformité et mesure : industrialiser sans se mettre en risque
Clarifier le cas d’usage avant de parler de fine-tuning LLM
Le fine-tuning LLM (ou affinage) n’est pas une baguette magique pour “faire connaître vos documents” à un modèle. Dans la plupart des entreprises, le vrai problème est ailleurs : réponses trop génériques, erreurs factuelles, incapacité à citer une source interne, ou langage qui ne colle pas à la marque et aux process. Avant de choisir RAG, LoRA ou QLoRA, posez une question simple : voulez vous apporter de la connaissance (documents à jour), ou changer le comportement (style, format, décisions, règles) ?
Un symptôme classique : “Le modèle hallucine sur nos produits.” Si la bonne réponse existe dans un PDF interne, entraîner le modèle est souvent la mauvaise réponse. Vous avez surtout besoin que l’assistant retrouve le bon passage et le cite. Autre symptôme : “Il ne respecte pas notre ton et nos règles.” Là, un fine-tuning peut aider, mais seulement si vous avez des exemples de conversations corrigées, et une manière de mesurer l’écart.
Formulez votre besoin métier sous forme de tâches observables : répondre à 50 questions SAV fréquentes, produire un email de relance conforme, résumer un incident selon un gabarit, extraire des clauses. Définissez ensuite des critères : taux de réponses correctes, taux de citations, temps moyen de traitement, réduction des escalades. Sans ce cadre, on choisit une technique parce qu’elle est à la mode, pas parce qu’elle réduit un coût ou un risque.
Pour éviter de “partir direct sur l’entraînement”, un cadrage pragmatique consiste à écrire noir sur blanc :
- Qui utilise l’assistant, et dans quel contexte (SAV niveau 1, juriste, technicien itinérant, back-office) ?
- Qu’est-ce qui est une “bonne réponse” : exacte, sourcée, actionnable, conforme à un gabarit, ou simplement utile ?
- Ce qui est interdit : inventer une référence, conseiller hors procédure, répondre sans source sur un point réglementaire, divulguer une donnée client.
- Ce qui doit rester à jour : gamme produit, tarifs, CGV, procédures de sécurité, modèles de clauses.
- Ce que vous acceptez en latence et en coût (ex. réponse en moins de 4–6 secondes, ou coût moyen par interaction sous un seuil interne).
Mini-schéma décisionnel (simple mais très efficace en atelier) :
- Si la vérité est dans un référentiel et doit être citée → privilégier RAG.
- Si la vérité est “connue” mais la réponse est mal formatée / pas conforme → tester LoRA (ou QLoRA).
- Si les deux sont vrais → viser une approche RAG + adaptation (souvent RAG d’abord, puis fine-tuning).
RAG : relier un LLM à vos documents, sans l’entraîner
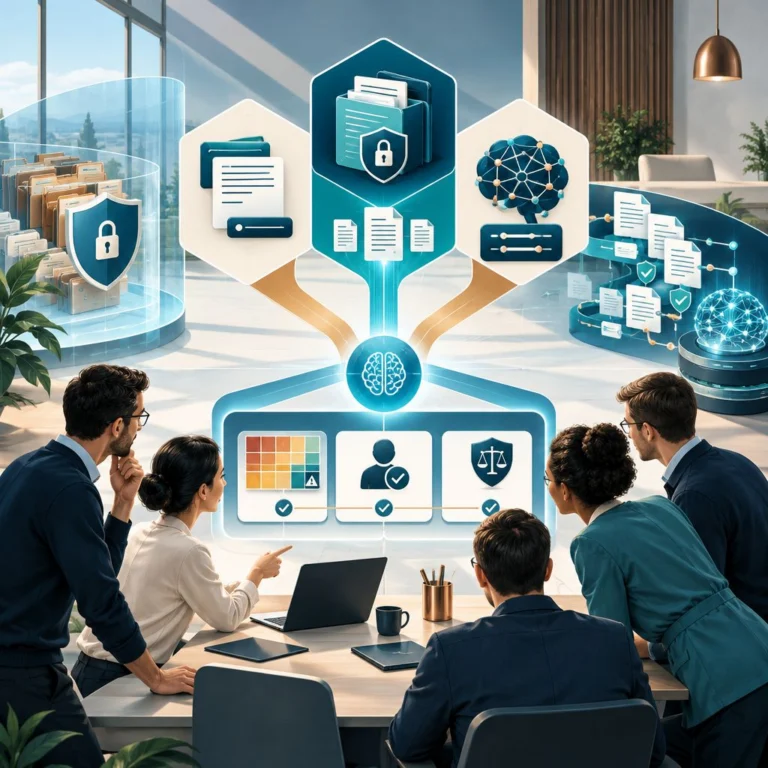
La RAG (Retrieval Augmented Generation) est une architecture où le LLM génère une réponse à partir de contenu récupéré dans vos bases documentaires. Elle s’appuie sur des embeddings (représentations numériques d’un texte) pour retrouver les passages pertinents via une recherche vectorielle, puis injecte ces passages dans le prompt. Dans l’article fondateur, Lewis et al. décrivent le principe ainsi : « Retrieval-Augmented Generation models combine a parametric memory (a seq2seq model) and a non-parametric memory (a dense vector index of Wikipedia) » (https://arxiv.org/abs/2005.11401).
Sur le terrain, RAG est souvent la voie la plus rapide pour obtenir un assistant “qui connaît l’entreprise”, parce qu’elle ne demande pas des milliers d’exemples annotés. Le travail critique est ailleurs : qualité des sources, découpage (chunking) des documents, métadonnées (produit, version, pays), stratégie de récupération (top-k, filtres), et consignes de génération (“réponds uniquement à partir des extraits, sinon dis je ne sais pas”). Un RAG bien conçu réduit l’hallucination, mais ne l’élimine pas : si la récupération est mauvaise, la génération l’est aussi.
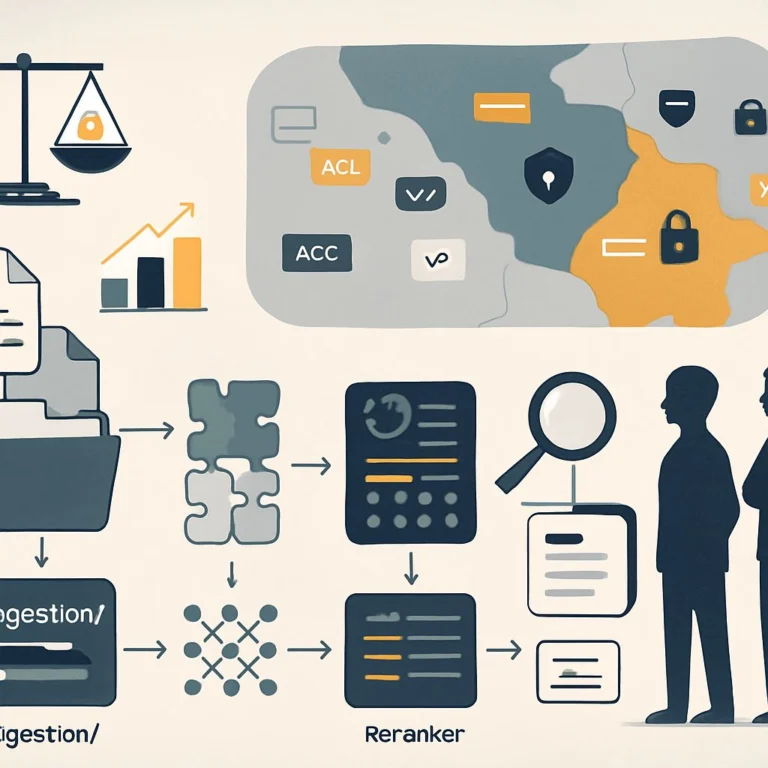
Un RAG “industrializable” ressemble souvent à une chaîne très concrète (et c’est souvent là que se gagnent les points) :
- Ingestion : collecter des versions maîtrisées (PDF, HTML, wiki interne, procédures), éviter les doublons et contenus obsolètes.
- Normalisation : extraire proprement le texte (titres, tableaux, listes), conserver les repères (numéro de section, page, date).
- Chunking : segmenter par unités utiles (sections, sous-sections, Q/R, articles), avec chevauchement si nécessaire.
- Indexation : embeddings + base vectorielle, avec métadonnées filtrables (pays, BU, version, date d’effet, type de doc).
- Retrieval : requête utilisateur → recherche (vectorielle + filtres), éventuellement re-ranking.
- Génération : consignes strictes + extraits + format de citation.
- Traçabilité : log des sources retournées, version des documents, et suivi des erreurs.
Paramètres qui changent vraiment la qualité (et donc à tester de manière contrôlée) :
| Levier RAG | Ce que ça change | Symptôme si mal réglé | Ajustement typique |
|---|---|---|---|
| Taille des chunks | précision vs contexte | “trop vague” ou “à côté” | segmenter par section; éviter les chunks “fourre-tout” |
| Chevauchement | continuité de sens | phrases coupées, définitions incomplètes | ajouter un léger overlap sur documents narratifs |
| top-k (nb d’extraits) | couverture vs bruit | réponse noyée / hors-sujet | réduire top-k ou ajouter re-ranking |
| Métadonnées | pertinence locale | mélange de versions/pays | filtrer par pays/produit/version |
| Consigne de réponse | discipline | hallucinations, absence de “je ne sais pas” | imposer refus si sources insuffisantes |
Côté coûts et délais, un POC RAG sérieux se joue souvent en 2 à 6 semaines selon l’état du référentiel documentaire. Les coûts sont majoritairement du temps d’intégration et d’indexation, plus le coût d’inférence du modèle. En production, surveillez trois métriques opérationnelles : latence (recherche + génération), taux de réponses avec source (citation), et recall de récupération (le bon passage est il retrouvé). Quand vous n’obtenez pas le passage attendu, améliorer l’index et le chunking apporte généralement plus que “entraîner un modèle”.
Deux points souvent sous-estimés en contexte multi-sites / multi-pays (cas fréquent en France/UE) :
- Variantes locales : mêmes produits mais procédures différentes selon pays, même acronymes mais sens différent selon BU. Les métadonnées deviennent un garde-fou (filtrer “FR”, “UE”, version, date d’effet).
- Versions : une procédure “valide” mais périmée est presque pire qu’une absence de réponse. Prévoyez un champ date d’entrée en vigueur et une règle de priorité.
LoRA : un fine-tuning frugal pour spécialiser un LLM
LoRA (Low Rank Adaptation) est une technique de fine-tuning dite PEFT (Parameter Efficient Fine Tuning). L’idée : on ne met pas à jour tous les poids du modèle, on ajoute de petites matrices apprenables (de rang faible) dans certains blocs, ce qui réduit fortement les paramètres entraînés. Les auteurs résument ainsi : « LoRA reduces the number of trainable parameters by learning pairs of rank-decomposition matrices while freezing the original weights » (https://arxiv.org/abs/2106.09685).
LoRA est adapté quand vous devez changer la manière de répondre plus que la connaissance brute : format de sortie strict (JSON, gabarit incident), vocabulaire métier récurrent, style rédactionnel, ou suivi de procédures. Exemple réaliste : un support technique qui doit produire un compte rendu structuré avec “symptômes, diagnostic, actions, pièces”, et respecter une terminologie interne. Ici, un jeu de 200 à 2 000 exemples de haute qualité peut déjà améliorer la cohérence, à condition que les exemples soient proches du réel.
Un bon indicateur que LoRA est pertinent : vous avez déjà une réponse “globalement juste” avec un prompt bien écrit, mais vous perdez du temps sur la post-édition (reformater, réordonner, supprimer des paragraphes inutiles, remettre les champs manquants, appliquer le ton). Le fine-tuning sert alors à rendre ce comportement systématique, pas à “remplir la mémoire” du modèle.
Points pratiques sur les données d’entraînement (souvent là que le projet se gagne) :
- Alignement entrée/sortie : chaque exemple doit expliciter l’entrée (contexte, consignes, éventuellement extrait(s) autorisés) et la sortie attendue.
- Couverture des cas “pièges” : demandes ambiguës, informations manquantes, demandes hors scope → il faut aussi des exemples de refus appropriés (“je ne peux pas conclure sans X”, “je ne trouve pas de source”).
- Cohérence des gabarits : si vous voulez un format strict, vos labels doivent être stricts (mêmes champs, mêmes conventions d’unités, même vocabulaire).
- Séparation train/test : gardez un lot figé (non vu à l’entraînement) pour éviter de confondre mémorisation et amélioration réelle.
Côté arbitrage, LoRA nécessite un pipeline d’entraînement, des données alignées (inputs, outputs attendus), et une évaluation. Comptez typiquement quelques jours à quelques semaines selon votre maturité MLOps et la complexité des jeux de données. Le coût GPU est inférieur à un fine-tuning complet, mais il existe. Point de vigilance : si vos exemples contiennent des informations sensibles, vous risquez de les “mémoriser”. Avant tout entraînement, appliquez une classification des données, la minimisation, et la suppression des identifiants inutiles.
Checklist rapide avant de lancer un LoRA (si vous cochez “non” trop souvent, revenez au cadrage) :
- Avez-vous une définition testable de “bonne sortie” (format, champs, ton, règles) ?
- Avez-vous au moins 200 exemples relus et validés par le métier (pas seulement “générés”) ?
- Avez-vous des exemples où la bonne réponse est de ne pas répondre ou de demander une précision ?
- Pouvez-vous mesurer l’amélioration sur un jeu figé (acceptation métier, conformité au format) ?
- Vos données d’entraînement sont-elles minimisées et conformes à vos règles internes ?
QLoRA : pousser l’adaptation plus loin avec la quantification 4 bits
QLoRA est une variante de LoRA qui combine l’adaptation de faible rang avec de la quantification (représenter les poids avec moins de bits, souvent 4 bits) pour réduire la mémoire GPU nécessaire pendant l’entraînement. Le papier de Dettmers et al. présente l’objectif clairement : « QLoRA finetunes 65B parameter models on a single 48GB GPU while preserving full 16-bit finetuning task performance » (https://arxiv.org/abs/2305.14314). L’intérêt pratique est de rendre l’adaptation de modèles plus grands accessible avec une infrastructure plus modeste.
Quand choisir QLoRA ? Quand LoRA “classique” est limité par la mémoire ou le coût, ou quand la taille du modèle apporte un gain réel sur vos tâches (raisonnement multi-étapes, consignes complexes, langage technique). Exemple : une équipe juridique qui veut une génération plus robuste sur des variations de clauses et des exceptions. Attention : un modèle plus gros ne compense pas un dataset brouillon. La qualité des exemples et la définition de “ce qui est correct” restent la priorité.
Dans la pratique, QLoRA devient intéressant dans des contextes où :
- vous avez besoin d’un modèle plus volumineux (meilleure robustesse aux consignes, meilleure tenue sur des documents longs, meilleure gestion de cas limites) mais votre capacité GPU est contrainte ;
- vous voulez expérimenter rapidement sur plusieurs variantes (rangs LoRA, jeux d’exemples, gabarits) sans exploser la facture d’infrastructure ;
- vous cherchez à versionner des “deltas” (adaptateurs) par équipe/pays/usage (ex. support FR vs support EN), tout en gardant un socle commun.
QLoRA apporte aussi des contraintes d’ingénierie : compatibilité des bibliothèques d’entraînement, stabilité numérique, et un peu plus de complexité de déploiement. En production, vous déployez souvent le modèle de base + les adaptateurs (les “deltas”) plutôt qu’un gros binaire retravaillé. C’est pratique pour la gouvernance (versionner, revenir en arrière), mais cela impose un registre de modèles et des procédures de validation. Point d’attention opérationnel : si votre objectif principal est la traçabilité (“d’où vient cette réponse ?”), QLoRA n’est pas une réponse en soi. Il améliore le comportement, mais il ne remplace pas les mécanismes de sources et de preuve que RAG traite naturellement.
Choisir RAG, LoRA ou QLoRA selon l’usage : une matrice décisionnelle
Pour choisir, partez de quatre questions. 1) La réponse correcte est elle déjà écrite dans un document interne ? 2) La forme attendue est elle normée (gabarit, champs obligatoires, style) ? 3) Le domaine change t il souvent (produits, réglementation, procédures) ? 4) Avez vous des exemples labelisés de bonne qualité ? Les réponses orientent naturellement vers RAG (connaissance), LoRA ou QLoRA (comportement), ou une combinaison.
Voici une lecture pratique, sans promesse de résultat garanti :
| Besoin dominant | Meilleur point de départ | Données nécessaires | Délai typique | Risques principaux |
|---|---|---|---|---|
| Connaissance à jour, citations, traçabilité | RAG | Documents + métadonnées | 2 à 6 semaines | mauvaise récupération, sources non fiables |
| Style, format strict, procédures stables | LoRA | 200 à 2 000 exemples (souvent plus) | 1 à 4 semaines | surapprentissage, fuite d’infos sensibles |
| Même besoin, mais modèle plus grand ou GPU limité | QLoRA | idem LoRA | 2 à 6 semaines | complexité entraînement, validation plus longue |
| “Vrai” + “bien dit” (sources + format) | RAG puis LoRA/QLoRA | docs + exemples | 4 à 10 semaines | empilement de complexité, évaluation mal définie |
Dans beaucoup d’entreprises, la meilleure séquence est progressive : (a) améliorer le cadrage des prompts et ajouter des règles de réponse, (b) construire un RAG robuste, (c) seulement ensuite tester LoRA ou QLoRA si le RAG répond correctement mais “mal” (ton, format, décisions). À noter : RAG et LoRA ne s’excluent pas. Un assistant peut utiliser RAG pour la vérité factuelle et LoRA pour la discipline de sortie, par exemple un JSON stable pour alimenter un ticketing.
Un scénario fréquent (et efficace) en environnement “terrain” :
- RAG pour récupérer : la bonne procédure (version, pays, produit) + les prérequis + les avertissements sécurité.
- LoRA pour produire : un compte rendu au format exigé par votre outil (champs obligatoires, ordre, vocabulaire), et pour standardiser les demandes de précision quand une information manque.
Si vous observez l’inverse (fine-tuning d’abord, documents ensuite), vous prenez souvent le risque de figer dans le modèle des pratiques qui changent : procédures, conditions commerciales, consignes de conformité. Dans des domaines soumis à mises à jour (assurance, banque, industrie réglementée), la capacité à “changer la vérité” vite est un argument très concret en faveur de RAG.
Données sensibles, conformité et mesure : industrialiser sans se mettre en risque
Avant tout fine-tuning LLM, fixez une règle : on n’entraîne pas sur des données qu’on n’est pas prêt à voir ressortir. Même si le risque de mémorisation varie selon les volumes et les méthodes, la prudence opérationnelle impose de supprimer ou pseudonymiser ce qui est inutile : noms, emails, numéros de contrat, identifiants de tickets, données de santé, etc. La bonne pratique est d’avoir une politique de classification, puis des jeux de données dérivés “entraînables” (minimisés) et des jeux “interdits”.
La conformité ne se limite pas aux données. En entreprise, vous devez aussi gérer les fournisseurs, l’hébergement, les sous-traitants, et les conditions contractuelles. Une check-list d’audit fournisseur permet d’anticiper : réversibilité, localisation, logs, clauses de confidentialité, gestion des incidents.
À l’échelle UE, il est aussi utile d’anticiper les exigences de documentation et de maîtrise des risques associées aux systèmes d’IA selon le contexte d’usage. Pour référence juridique, le texte du règlement européen sur l’IA (AI Act) est accessible sur EUR-Lex : https://eur-lex.europa.eu/eli/reg/2024/1689/oj. Sans rentrer dans un débat général, retenez surtout l’implication opérationnelle : plus l’usage est sensible, plus vous aurez besoin de traçabilité (données, versions, évaluations, limites connues, procédures de supervision).
Enfin, mesurez avec un protocole simple mais strict. Constituez un jeu d’évaluation de 30 à 100 cas réels, figés, représentatifs des cas “faciles” et “pièges”. Mesurez au minimum : exactitude (ou score d’acceptation métier), taux de refus approprié (“je ne sais pas”), présence de sources pour un RAG, et coût par réponse. Ajoutez une évaluation humaine en double lecture sur un échantillon, car les métriques automatiques ratent souvent les nuances métier. Un modèle qui “répond plus” n’est pas un modèle qui “répond mieux”.
Pour rendre l’évaluation actionnable (et comparable entre itérations), vous pouvez utiliser une grille courte, par exemple notée 0/1 :
| Critère (par cas) | Score 0 | Score 1 |
|---|---|---|
| Exactitude métier | faux / trompeur | correct et utilisable |
| Conformité au format | champs manquants / ordre incorrect | format respecté |
| Traçabilité (RAG) | pas de source / source non pertinente | source(s) pertinentes citées |
| Gestion de l’incertitude | répond malgré manque d’info | demande une précision ou refuse à bon escient |
| Sécurité/conformité | divulgue / conseille hors règle | respecte les garde-fous |
Cette approche évite de “piloter au ressenti” et aide à décider : améliorer la récupération (RAG), enrichir les consignes, ou investir dans LoRA/QLoRA.
Première étape concrète à réaliser : collectez 40 questions réelles (SAV, juridique, technique ou commercial), rédigez la réponse attendue validée métier, puis utilisez ce jeu comme référence pour comparer, dans cet ordre, (1) prompt amélioré, (2) RAG minimal, (3) LoRA ou QLoRA si et seulement si le besoin concerne le comportement plutôt que l’accès à l’information.