Table des matières :
- Partir du risque métier plutôt que de la « magie » IA
- Mettre en place un registre de modèles : l’inventaire qui évite les angles morts
- Auditer un système IA : preuves, traçabilité et contrôle des tiers
- Gérer le cycle de vie : de l’idée au retrait, sans dériver en production
- Données sensibles : classifier, minimiser, tracer et purger
- Mesurer et surveiller : qualité, dérives, sécurité et coûts
- Mettre des responsabilités claires : RACI, comités et procédures
- Première action cette semaine : créer un registre minimal et choisir 3 métriques
Partir du risque métier plutôt que de la « magie » IA
Déployer une IA en entreprise, ce n’est pas « mettre un modèle en production ». C’est introduire un nouveau composant décisionnel qui peut impacter la conformité, la sécurité, la qualité de service et la réputation. Les équipes le constatent vite avec les assistants grand public : réponses plausibles mais fausses, oubli des règles internes, et incapacité à citer des sources. La gouvernance sert d’abord à réduire ces risques, puis à accélérer la livraison en évitant les débats ad hoc à chaque projet.
Le point de départ utile est la question métier : qu’est-ce qui peut mal se passer et combien cela coûte. Sur un cas service client, une réponse erronée peut générer des réclamations et des gestes commerciaux. Sur un cas juridique, une hallucination peut créer un risque contractuel. Sur un cas technique, une mauvaise recommandation peut déclencher un incident. Une gouvernance pragmatique se juge à sa capacité à prévenir ces scénarios, pas à la sophistication du modèle.
Pour rendre cette analyse actionnable dès le cadrage, beaucoup d’équipes utilisent une matrice simple gravité × vraisemblance (même en mode atelier d’1 heure). Exemple minimal :
| Scénario | Gravité (1–4) | Vraisemblance (1–4) | Risque | Contrôle prioritaire |
|---|---|---|---|---|
| Hallucination sur une clause contractuelle | 4 | 2 | Élevé | Réponse avec sources + escalade juridique obligatoire |
| Fuite de données sensibles via prompt | 4 | 2–3 | Élevé | Filtrage/masquage + politiques + tests d’injection |
| Mauvaise procédure support (SAV) | 3 | 3 | Élevé | Corpus RAG validé + monitoring des erreurs graves |
| Réponse non conforme au ton de marque | 2 | 3 | Moyen | Prompt + règles + validation échantillonnée |
Cette quantification n’est pas parfaite, mais elle force une décision : où met-on des garde-fous “non négociables” (refus, escalade, journalisation, limitation du périmètre), et où accepte-t-on un risque résiduel.
Les cadres existants aident à structurer sans réinventer. Le NIST rappelle que la gestion du risque IA vise à favoriser une IA « trustworthy ». Dans NIST AI RMF 1.0 (2023), l’IA digne de confiance est décrite par des caractéristiques comme « valid and reliable, safe, secure and resilient, accountable and transparent, explainable and interpretable, privacy-enhanced, and fair » (source : NIST, AI RMF 1.0, NIST AI RMF 1.0 (PDF)). La gouvernance que nous détaillons ici se traduit concrètement par trois objets : un registre de modèles, des audits, et un cycle de vie contrôlé.
Mettre en place un registre de modèles : l’inventaire qui évite les angles morts
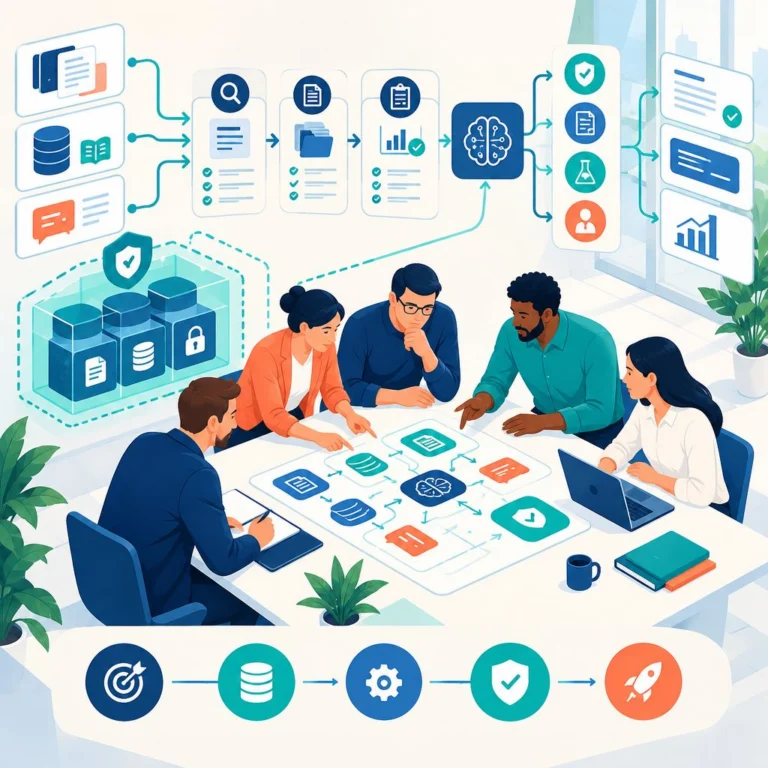
Un registre de modèles est l’équivalent, pour l’IA, d’un inventaire d’applications et de composants critiques. Il centralise l’identité d’un modèle (ou d’un système IA), ses versions, son usage, ses données, ses évaluations, et les responsables. C’est particulièrement important depuis l’arrivée des LLM, car « le modèle » ne se résume plus à un fichier. Un assistant de support inclut souvent un modèle de base, un prompt système, des règles de sécurité, un pipeline RAG (Retrieval-Augmented Generation), des embeddings, un index de documents et des métriques en production.
Définition rapide des briques qu’on doit tracer :
1) Embeddings : représentation vectorielle d’un texte, utilisée pour retrouver des documents proches sémantiquement.
2) RAG : méthode où le modèle génère une réponse à partir de documents récupérés au moment de la requête, plutôt que d’« apprendre » ces documents. Cela réduit le besoin d’entraînement et facilite la mise à jour.
3) Fine-tuning : ré-entraînement d’un modèle (souvent sur un sous-ensemble de paramètres) pour l’adapter à un style, un vocabulaire ou une tâche.
4) LoRA (Low-Rank Adaptation) : technique de fine-tuning « léger » où l’on apprend de petites matrices d’adaptation, moins coûteuses à stocker et à déployer que de réécrire tout le modèle.
Concrètement, un registre utile en entreprise ne cherche pas la perfection dès le jour 1. Il doit permettre de répondre en moins de 10 minutes à des questions simples mais critiques : quel modèle répond aux clients, avec quelle version, où sont les logs, qui valide les changements, et quels documents alimentent le RAG. Un modèle de fiche minimum (souvent au format tableur au début) inclut : identifiant unique, description du cas d’usage, périmètre, criticité, données en entrée, données en sortie, base légale si données personnelles, modèle fournisseur ou interne, version, prompt système, sources RAG, métriques d’évaluation, date de dernière revue, et « owner » métier.
Un ajout très utile, surtout en contexte France / UE, est de relier ce registre IA à deux objets déjà obligatoires ou courants :
- le registre des traitements (article 30 RGPD) quand des données personnelles sont impliquées (même si le projet est “interne”) ;
- la CMDB / inventaire applicatif côté DSI pour éviter que l’IA soit un “shadow IT” non monitoré (DNS, endpoints, comptes de service, secrets, accès).
Exemple concret : un assistant interne “FAQ RH” peut sembler peu risqué… jusqu’à ce que l’on découvre qu’il indexe des procédures contenant des informations nominatives (arrêts maladie, sanctions, etc.) ou qu’il envoie des extraits au fournisseur via une API hors UE. Sans registre, ces angles morts restent invisibles.
À partir d’un certain volume, on industrialise. Les registres outillés (internes ou via des composants MLOps) doivent gérer la traçabilité : versioning des modèles, des prompts, des datasets, et des pipelines. L’objectif n’est pas de « tout stocker », mais de pouvoir reproduire une décision : avec quel artefact et quel paramétrage une réponse a été produite (ou, a minima, l’expliquer). C’est précisément l’esprit des pratiques de documentation comme les model cards. Mitchell et al. définissent ces fiches ainsi : « Model cards are short documents accompanying trained machine learning models » (Mitchell et al., 2019, “Model Cards for Model Reporting”, arXiv).
Pour éviter un registre “théorique”, une astuce opérationnelle consiste à séparer “ce que l’on sait” de “ce que l’on doit prouver” :
- Savoir : description, owner, périmètre, architecture (modèle + RAG + prompts), dépendances.
- Prouver : tests, validations, décisions d’arbitrage, dates de revue, preuves d’opt-out ou clauses contractuelles quand un tiers est impliqué.
Auditer un système IA : preuves, traçabilité et contrôle des tiers
Un audit IA n’est pas un exercice théorique d’éthique. C’est une vérification structurée de preuves : le système fait-il ce qu’il dit, dans les limites déclarées, avec des contrôles adaptés au risque. L’audit couvre généralement trois axes : conformité (règles internes, réglementaire), sécurité (protection des données, robustesse), et performance (qualité mesurée, dérives). L’enjeu est de produire des éléments opposables : politiques, rapports d’évaluation, résultats de tests, et décisions de validation.
Dans beaucoup d’organisations, le point faible est la chaîne fournisseur. Vous utilisez peut-être un modèle via API, un outil d’annotation, un prestataire d’intégration, un hébergeur, et une solution de recherche documentaire. Chacun introduit un risque et des obligations (localisation des données, sous-traitance, conservation des logs, etc.). Une bonne pratique est d’aligner l’audit IA avec votre audit fournisseurs existant, en ajoutant des contrôles spécifiques IA : utilisation des données pour entraîner, options d’opt-out, isolation des tenants, procédures d’incident, et SLA sur la suppression des données.
Voici une check-list d’audit IA (volontairement “preuve-centric”), utile pour un LLM en API comme pour un modèle interne :
- Cartographie et périmètre
- cas d’usage, utilisateurs, canaux (web, email, chat), pays/entités concernées ;
- données en entrée/sortie (dont logs), durée de conservation, lieux d’hébergement.
- Contrats et sous-traitance
- clauses sur l’usage des données (entraînement, amélioration de service, rétention) ;
- sous-traitants ultérieurs (chaîne de traitement), transferts hors UE si applicable.
- Sécurité
- gestion des secrets (clés API), segmentation réseau, contrôle d’accès (RBAC) ;
- tests de prompt injection et d’exfiltration de données (scénarios documentés).
- Qualité et limites
- protocole d’évaluation (jeu de tests, critères d’acceptation, résultats) ;
- limites explicitement communiquées (ce que l’IA ne doit pas faire).
- Exploitation
- monitoring (qualité, sécurité, coûts), gestion d’incident, rollback version prompt/modèle ;
- “change management” : qui approuve, qui déploie, qui est informé.
Côté réglementation, le paysage européen a évolué. L’EU AI Act (adopté en 2024, application progressive) impose, pour certains systèmes, des exigences de gouvernance, documentation, gestion des risques et qualité. Même si tous vos cas ne sont pas « high-risk », s’aligner sur ces exigences dès maintenant évite des refontes. Référence officielle (EUR-Lex) : EU AI Act (EUR-Lex). Dans les faits, l’audit doit vérifier des éléments très concrets : qui approuve les changements, comment vous testez avant mise en prod, comment vous gérez les incidents, et comment vous informez les utilisateurs quand c’est nécessaire.
Point d’attention très “terrain” : l’audit doit couvrir le système complet, pas uniquement le modèle. Une dérive de qualité provient souvent de :
- documents RAG obsolètes (politique non mise à jour),
- droits d’accès incohérents (un utilisateur accède à des documents qu’il ne devrait pas),
- modification “mineure” du prompt qui change la politique de refus,
- changement d’index/embedding qui dégrade la récupération.
Gérer le cycle de vie : de l’idée au retrait, sans dériver en production
Parler de cycle de vie IA permet de sortir du piège « entraînement ou rien ». La majorité des projets échouent parce qu’ils sautent des étapes : cadrage de l’usage, définition des critères d’acceptation, qualité des données, et mise sous contrôle en production. Un cycle de vie gouverné, c’est une suite d’étapes avec des points de passage obligatoires (stage gates) et des livrables attendus.
Une séquence pragmatique en 7 étapes fonctionne bien :
1) Cadrage : objectif, utilisateurs, risques, et impact si erreur.
2) Choix d’approche : prompt + règles, RAG, fine-tuning, ou combinaison.
3) Préparation données : qualité, droits d’usage, anonymisation si besoin.
4) Évaluation hors production : jeux de tests, scénarios d’échec, red teaming.
5) Déploiement contrôlé : canary, A/B test, garde-fous.
6) Monitoring : dérive, coûts, latence, incidents.
7) Retrait : décommission, purge, archivage des preuves.
Pour rendre ces “stage gates” concrets, vous pouvez associer à chaque étape un livrable court (1 à 3 pages) et un go/no-go explicite. Exemple :
- Fin cadrage : matrice de risques + critères d’acceptation + décision “humain dans la boucle ou non”.
- Fin évaluation hors prod : rapport de tests (qualité, sécurité, conformité) + limites + plan de monitoring.
- Avant déploiement : runbook (rollback, seuils d’alerte, procédure incident IA).
L’étape 2 mérite une règle simple : si votre besoin est « connaître nos documents à jour », commencez par du RAG plutôt que par de l’entraînement. Le RAG demande moins de données labellisées, se met en place plus vite, et réduit le risque de mémorisation de données sensibles (puisqu’on privilégie la récupération de sources à la “mémorisation” par apprentissage). À l’inverse, le fine-tuning est pertinent quand vous devez changer un comportement stable : format de sortie strict, style, classification, ou extraction structurée.
Ordres de grandeur (très variables) : un MVP RAG peut se monter en 2 à 6 semaines avec une équipe réduite et un corpus documentaire propre ; un fine-tuning sérieux peut prendre 4 à 12 semaines, exiger des milliers à des dizaines de milliers d’exemples, et nécessite un protocole d’évaluation plus strict. Une manière simple de décider : si vous ne savez pas mesurer “avant/après” sur un jeu de tests, vous n’êtes pas prêt à fine-tuner.
Données sensibles : classifier, minimiser, tracer et purger
La gouvernance IA échoue souvent sur un point : on met des données dans le système avant d’avoir décidé ce qui est autorisé. Avant tout entraînement, et même avant un POC, la règle est : classifier, minimiser, tracer. La classification n’est pas un exercice documentaire, c’est une cartographie des flux par application, réseau et usage.
Sur le plan pratique, la minimisation se traduit par des choix d’architecture. Exemple : pour un assistant RH, il est rarement nécessaire d’envoyer des identifiants, des salaires, ou des informations médicales au modèle. On peut :
1) masquer ou supprimer les champs sensibles en amont,
2) remplacer par des identifiants internes non signifiants,
3) restreindre le RAG à des documents déjà validés et non confidentiels,
4) conserver les détails dans des systèmes transactionnels, et ne demander au modèle qu’une reformulation ou un routage.
Une règle utile (et facile à auditer) : “ce qui est interdit dans un email client est interdit dans un prompt”. Cela se formalise en politique interne + contrôles techniques (DLP, regex, détecteurs de secrets, etc.) + échantillonnage de logs (avec accès restreint).
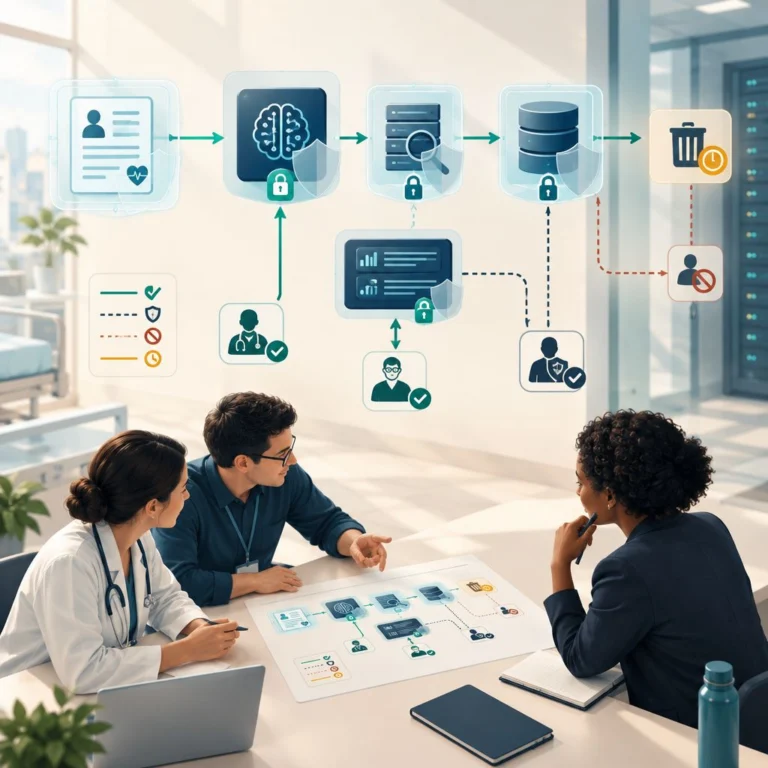
La traçabilité et la purge complètent le triptyque. Vous devez savoir où vont les prompts, les réponses, les documents indexés, et les logs, et pendant combien de temps. Pour les données personnelles, il faut une base légale, une information adaptée, des durées de conservation, et des mécanismes de suppression. Pour les données sensibles (secrets industriels, codes sources, dossiers clients), la gouvernance exige un filtrage et des règles explicites : ce qui est interdit d’entrer dans le prompt, ce qui peut être indexé, et ce qui doit rester dans un coffre-fort applicatif hors IA.
Deux points souvent sous-estimés en UE :
- AIPD/DPIA : si le traitement est susceptible d’engendrer un risque élevé pour les droits et libertés, l’analyse d’impact peut s’imposer (et elle est un excellent support de gouvernance, même quand elle n’est pas strictement obligatoire).
- Droits d’accès au corpus RAG : indexer n’est pas “neutre”. Un index de recherche mal cloisonné peut rendre des documents “découvrables” à des personnes qui n’y avaient pas accès, même si l’application source était correctement sécurisée.
Pour un cadre de référence public en France sur l’articulation entre IA et données personnelles, le dossier CNIL “Intelligence artificielle” est un bon point d’entrée : CNIL — Intelligence artificielle (utile notamment pour rappeler les principes RGPD : finalité, minimisation, durée, sécurité, information).
Mesurer et surveiller : qualité, dérives, sécurité et coûts
Un registre et des audits ne servent à rien si vous ne mesurez pas ce que fait le système. La difficulté avec les LLM est qu’on ne peut pas se contenter d’une « accuracy » globale. Il faut des métriques alignées sur le métier : taux de réponses exploitables, taux de refus justifiés, taux d’escalade vers un humain, temps moyen de résolution, et surtout taux d’erreurs graves (celles qui coûtent cher). Dès le cadrage, fixez 3 niveaux : acceptable, dégradé, inacceptable, avec des actions associées (ex. limiter le périmètre, forcer l’escalade, désactiver une fonctionnalité).
Une manière simple d’éviter les débats interminables est de définir une taxonomie d’erreurs (3 à 6 catégories) et d’y rattacher vos métriques. Exemple :
- Erreur factuelle (information fausse),
- Erreur de conformité (conseil non autorisé, absence de disclaimer requis),
- Erreur de sécurité (révélation d’une info sensible, contournement d’accès),
- Erreur de routage (mauvais service, mauvaise procédure),
- Erreur de format (JSON invalide, champs manquants).
La mesure doit couvrir la partie « récupération » du RAG et la partie « génération ». Côté récupération, suivez par exemple : recall sur un jeu de requêtes, proportion de citations correctes, fraîcheur des documents, et taux de réponses sans source. Côté génération, évaluez : respect du format (JSON valide, champs obligatoires), exactitude factuelle sur un dataset interne, et conformité (pas de données sensibles, pas d’instructions interdites). Une pratique robuste consiste à maintenir un jeu de tests versionné : une centaine de requêtes représentatives au début, puis plusieurs milliers lorsque le système devient critique.
Table de démarrage (3 métriques “RAG-ready”) :
| Métrique | Définition opérationnelle | Pourquoi c’est utile | Seuil d’alerte (exemple) |
|---|---|---|---|
| Réponses avec source | % de réponses contenant ≥ 1 citation exploitable | Réduit l’hallucination “non détectée” | < 85% sur la semaine |
| Escalade | % de conversations transférées à un humain | Indique limites, manque de docs, ou prompt trop prudent | > 30% (à ajuster par canal) |
| Erreurs graves | # d’incidents “catégorie rouge” / 1 000 conversations | Mesure l’impact réel | > 1 / 1 000 |
La surveillance en production doit aussi couvrir les risques de sécurité et les coûts. Ajoutez des alertes sur : augmentation des tokens, latence, taux d’erreurs, et changements de distribution (drift) sur les requêtes. Pour la sécurité, testez régulièrement l’injection de prompt et la fuite de données via des scénarios de red teaming. Un référentiel pratique, orienté menaces spécifiques LLM (injection, exfiltration, etc.), est l’OWASP Top 10 for LLM Applications (utile pour alimenter vos scénarios de tests, sans dépendre d’un fournisseur).
Sans promesse de perfection, l’objectif est de détecter tôt, corriger vite, et documenter les actions (correctif prompt, purge d’un document RAG, ajout d’un filtre, amélioration du jeu de tests). Sur le volet “système de management”, ISO/IEC 42001:2023 fournit un cadre pour organiser la gouvernance et l’amélioration continue d’un système de management de l’IA.
Mettre des responsabilités claires : RACI, comités et procédures
La gouvernance IA se casse quand « tout le monde » est responsable. Un modèle en production a besoin d’un owner métier (responsable du résultat), d’un owner technique (responsable du fonctionnement), et de fonctions de contrôle (sécurité, juridique, DPO, risque). Formalisez un RACI simple : qui Rédige, qui Approuve, qui Consulte, qui Informe, pour chaque étape du cycle de vie. Sans cela, les validations se font par messages, et les décisions ne sont pas traçables.
Un RACI minimal (à adapter) peut ressembler à ceci :
| Activité | Owner métier | Owner technique | RSSI/Sécurité | DPO/Juridique | Exploitation |
|---|---|---|---|---|---|
| Cadrage & critères d’acceptation | A | C | C | C | I |
| Choix d’architecture (RAG / FT / règles) | C | A | C | I | C |
| Validation données (droits, minimisation) | C | R | C | A | I |
| Évaluation & tests sécurité | C | R | A | C | C |
| Go-live & rollback plan | A | R | C | I | A/R |
| Revue trimestrielle (qualité, incidents) | A | R | C | C | R |
Le registre de modèles devient alors un outil d’arbitrage. Il doit indiquer : criticité, populations impactées, dépendances, et date de prochaine revue. Sur un assistant interne à faible risque, une revue trimestrielle peut suffire. Sur un outil qui produit des recommandations commerciales ou juridiques, vous voudrez des revues plus fréquentes, des tests plus stricts, et parfois une validation formelle par le métier. L’idée n’est pas de ralentir tous les projets, mais d’appliquer un contrôle proportionné (principe particulièrement important dans des organisations multi-entités en France/UE, où les responsabilités DPO/RSSI peuvent varier selon les filiales).
Enfin, prévoyez une procédure d’incident IA. Elle ressemble à une procédure SRE classique, mais avec des catégories spécifiques : hallucination à impact client, fuite de données, biais de routage, mauvaise citation de sources, ou comportement non conforme suite à un changement de prompt. Chaque incident doit produire un apprentissage : mise à jour des garde-fous, enrichissement du jeu de tests, correction des données RAG, ou, parfois, décision d’arrêter l’IA sur un périmètre.
Première action cette semaine : créer un registre minimal et choisir 3 métriques
Prenez un périmètre limité mais réel : un assistant interne, un prototype service client, ou un outil d’extraction documentaire. L’objectif n’est pas de « governer toute l’IA » en une fois, mais de poser un standard réutilisable. Réunissez en 60 à 90 minutes le métier, la data, la sécurité et le juridique pour remplir une fiche unique dans un registre minimal.
Pour gagner du temps, vous pouvez démarrer avec une fiche “une page” (copiable dans un tableur) :
| Champ | Exemple |
|---|---|
| ID système IA | IA-SUP-001 |
| Cas d’usage | Assistant support interne (procédures IT) |
| Owner métier / Owner technique | Resp. Support / Lead IA |
| Périmètre & utilisateurs | 200 agents, France, intranet |
| Données en entrée | Questions agents + logs conversation |
| Données en sortie | Réponses + citations + score confiance |
| Données personnelles ? | Oui (potentiel) → minimisation + base légale + durée |
| Architecture | LLM + RAG + filtres + règles de refus |
| Sources RAG | Base de connaissances validée (liste + owners) |
| Critères d’acceptation | ≥ 85% réponses avec source, 0 fuite PII en tests |
| Dernière évaluation | date + lien rapport |
| Prochaine revue | date |
Dans cette fiche, imposez trois champs non négociables : 1) qui est l’owner métier, 2) quelles données entrent et sortent, 3) quels sont les critères d’acceptation. Ajoutez ensuite trois métriques suivies chaque semaine pendant un mois. Exemple pour un assistant RAG : taux de réponses avec au moins une source, taux d’escalade vers un humain, et coût moyen par conversation (tokens ou euros). Ce trio suffit souvent à révéler les vrais problèmes : documents mal indexés, prompts trop permissifs, ou coûts qui dérivent.
Une fois ce premier modèle enregistré et mesuré, vous aurez la base factuelle pour décider si l’étape suivante est nécessaire. Très souvent, le meilleur investissement n’est pas l’entraînement, mais l’amélioration du corpus, du routage documentaire, des droits d’accès et du protocole d’évaluation. Si, au contraire, vous observez un besoin stable non couvert par le RAG (format strict, classification récurrente, style imposé), vous pourrez justifier un fine-tuning avec un budget, un délai et un volume de données réalistes, et surtout un plan de mesure avant et après.