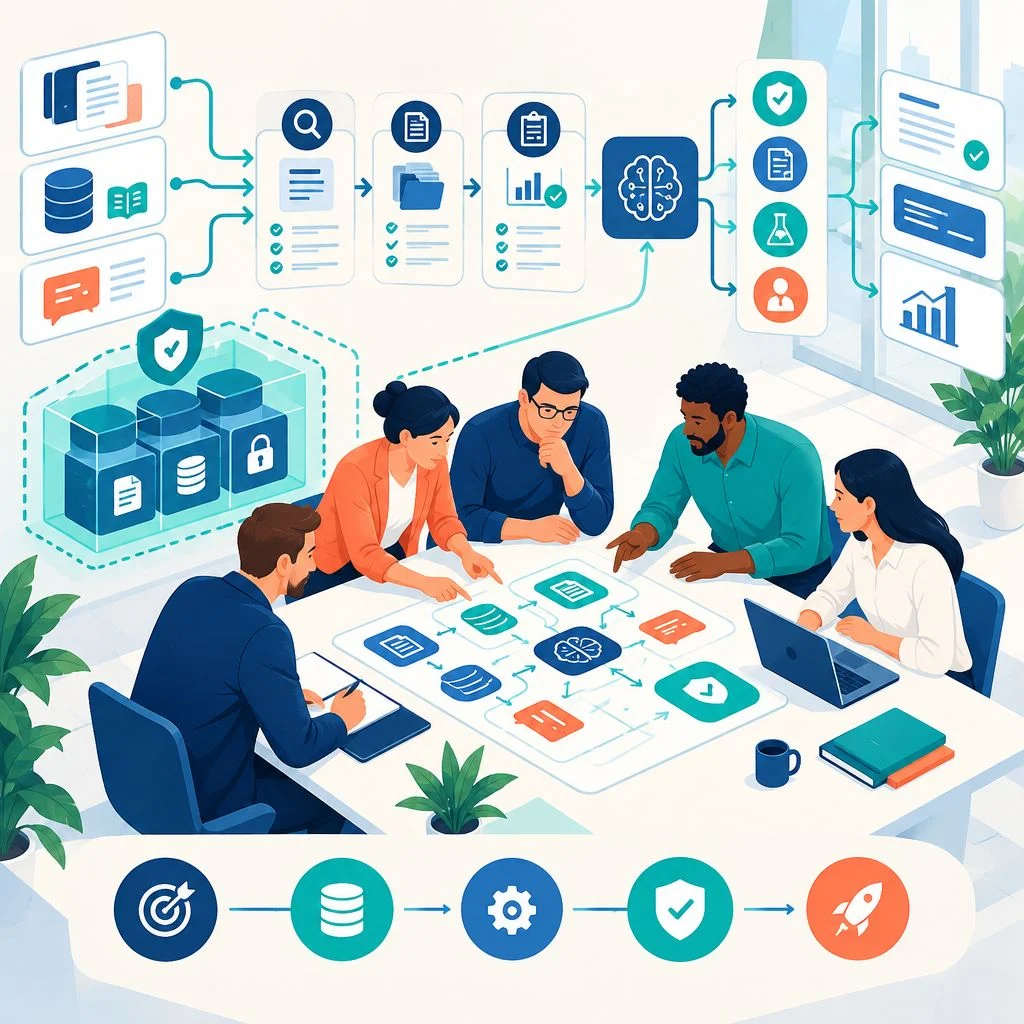
Table des matières :
- Cadrer une IA d’entreprise par le besoin, pas par le modèle
- Cartographier les données et les risques avant toute expérimentation
- Choisir la bonne approche : prompting, RAG ou entraînement (fine-tuning)
- Mesurer ce qui marche : jeux de test, évaluations et sécurité applicative
- Industrialiser : gouvernance, MLOps et audits fournisseurs
- Déployer de façon sécurisée : garde-fous, données sensibles et exploitation
- Première action concrète : lancer un diagnostic en 2 heures avec 10 cas réels
Cadrer une IA d’entreprise par le besoin, pas par le modèle
Déployer une IA d’entreprise ne commence pas par le choix d’un LLM, mais par un diagnostic métier. Le symptôme est souvent le même : un assistant grand public répond « à peu près », ignore votre jargon et invente des détails. La question utile n’est donc pas « faut-il entraîner un modèle ? », mais « quelle décision, quel geste opérationnel ou quel risque voulons-nous améliorer ou réduire ? ». Un bon cadrage transforme une idée floue (ex. « automatiser le support ») en un objectif mesurable (ex. réduire le temps moyen de traitement de 15 % sur les tickets de niveau 1, tout en maintenant un taux d’escalade acceptable).
Pour gagner en clarté dès le départ, formulez votre besoin sous la forme Action → Contexte → Sortie attendue → Contrôle. Exemple concret : « Répondre aux questions SAV sur les garanties (action) à partir des CGV à jour par pays (contexte) en citant l’article exact et en indiquant les exclusions (sortie) sinon escalader vers un humain (contrôle). » Ce format aide à limiter la dérive vers un « chatbot généraliste » et oblige à définir où la valeur se crée.
Concrètement, démarrez par un diagnostic en 4 éléments, chacun documenté sur une page. 1) Cas d’usage et périmètre (qui utilise, quand, sur quels canaux). 2) Définition de la “bonne réponse” (format, sources attendues, règles métier). 3) Critères de succès (KPI métier et KPI techniques). 4) Contraintes (données sensibles, exigences de traçabilité, langues, latence, budget). Cette fiche de cadrage sert de contrat entre métiers, DSI, data et sécurité.
Pour rendre l’exercice opérationnel, partez d’un corpus de situations réelles. Par exemple : 30 questions fréquentes du service client, 20 extraits de procédures internes et 10 cas « pièges » connus (exceptions, clients VIP, clauses contractuelles). L’objectif du diagnostic est de vérifier deux choses : la valeur attendue (réduction de charge, amélioration de la qualité) et la nature de l’effort (documentation, gouvernance, intégration SI). Très souvent, on découvre que le problème n’est pas l’IA elle-même, mais l’accès aux bonnes sources, la qualité des procédures ou l’ambiguïté des consignes.
Ajoutez un test simple qui évite beaucoup d’illusions : demandez à 2 personnes métier de noter “la bonne réponse” sur 5 des 10 cas (sans IA). Si elles ne sont pas d’accord, l’IA ne « réglera » pas le problème : il faut d’abord aligner la règle métier, la source de vérité et le format de sortie. À l’inverse, si l’accord est fort mais que la réponse est lente ou coûteuse à produire, vous avez un signal que l’automatisation peut créer de la valeur.
Cartographier les données et les risques avant toute expérimentation
Un angle mort fréquent dans les projets d’IA d’entreprise : brancher trop vite des documents ou des tickets sans cartographier les données. Avant de parler d’entraînement, il faut répondre à trois questions simples : quelles données entrent dans le système, où transitent-elles et qui peut les voir. Ce travail ressemble plus à de l’architecture et de la conformité qu’à du machine learning, mais il conditionne la possibilité même de déployer.
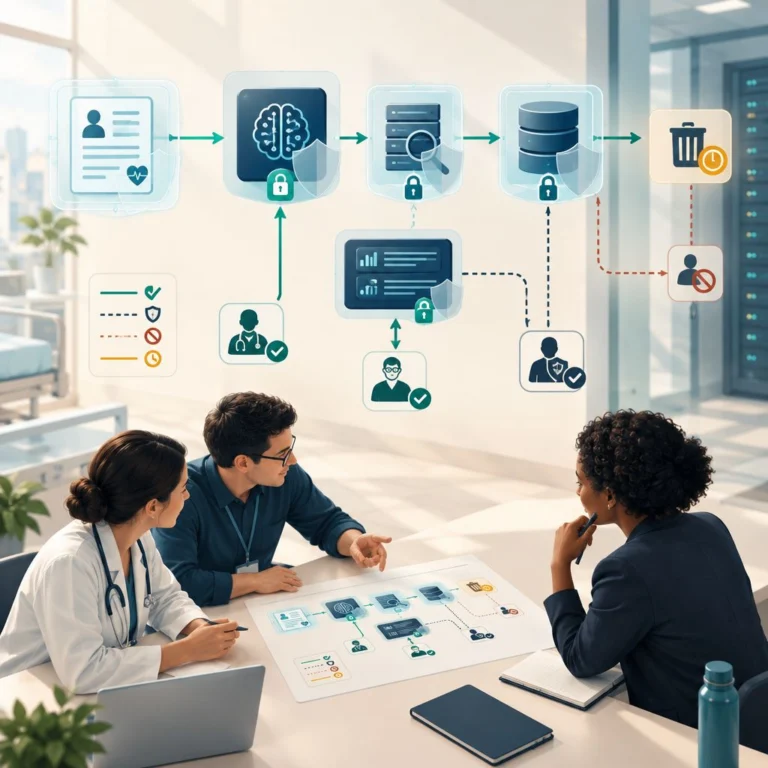
Commencez par une classification des données (publiques, internes, confidentielles, sensibles) et une cartographie des flux. Cela permet de décider quelles sources peuvent alimenter un assistant et à quelles conditions (chiffrement, masquage, restrictions d’accès). Pour une méthode pas à pas, vous pouvez vous appuyer sur : Classification des données : cartographier flux sensibles par application et réseau. Dans les organisations manipulant des données de santé, la rigueur doit être encore plus élevée, notamment sur la conservation et la traçabilité : Protection des données de santé IA : cartographier flux, accès et conservation.
Côté cadre légal, rappelez-vous qu’une IA n’est pas une « boîte noire » hors du droit. Le RGPD impose notamment la minimisation et la protection des données dès la conception. Le texte de référence parle explicitement de « protection des données dès la conception et protection des données par défaut » (article 25 du RGPD, version française), ce qui revient à intégrer les contrôles dans l’architecture dès le départ, pas en correctif après coup. Référence : Règlement général sur la protection des données (RGPD), version française.
Dans un contexte France/UE, pensez aussi à l’articulation avec vos obligations internes : registre des traitements (si données personnelles), gestion des habilitations et, si nécessaire, AIPD/DPIA lorsque le traitement est susceptible d’engendrer un risque élevé pour les droits et libertés. Sans entrer dans une « paperasse » inutile, l’intérêt opérationnel est simple : une AIPD bien faite force à documenter les flux, les finalités, les durées de conservation et les mesures de sécurité — exactement ce dont un projet d’IA a besoin pour passer en production sans blocage tardif.
Sur le plan pratique, avant toute expérimentation, adoptez trois réflexes. 1) Nettoyer et filtrer : retirer les données inutiles, les doublons et les documents obsolètes. 2) Traiter les données sensibles : pseudonymiser, masquer ou exclure selon les exigences. 3) Tracer : conserver une preuve de provenance (source, date, propriétaire, base légale si données personnelles). C’est aussi à ce moment que vous fixez la règle : « aucune donnée sensible ne sort du périmètre autorisé » et « pas d’entraînement sur des contenus non validés ».
Une bonne pratique très « terrain » : constituez un tableau de cartographie (même simple) pour chaque source candidate (SharePoint, GED, outil de ticketing, intranet, dossiers réseau) avec : propriétaire, niveau de sensibilité, durée de validité, règle d’accès, risque principal (ex. fuite d’un contrat, divulgation de données RH, informations de santé). Ce tableau devient un outil de pilotage : on sait quoi indexer en premier, quoi exclure et quoi remettre à niveau avant d’alimenter l’assistant.
Choisir la bonne approche : prompting, RAG ou entraînement (fine-tuning)
Une IA d’entreprise « qui connaît vos documents » ne nécessite pas systématiquement un entraînement. Une progression souvent pertinente consiste à commencer par le prompting et les gabarits, puis à envisager le RAG, et enfin le fine-tuning si un écart de performance persiste.
Le RAG (Retrieval-Augmented Generation) consiste à faire chercher au modèle des passages pertinents dans vos documents, puis à lui demander de répondre en s’appuyant sur ces extraits. Le cœur technique repose souvent sur un index d’embeddings (représentations vectorielles de textes) pour retrouver rapidement les morceaux proches sémantiquement de la question. Avantage : vous mettez à jour les connaissances en actualisant les documents, sans réentraîner le modèle. Inconvénient : cela exige une bonne gouvernance documentaire, des droits d’accès stricts et une évaluation sérieuse du « grounding » (réponse réellement appuyée sur des sources). Pour un cadrage complet (architecture, sécurité, ROI) : RAG et recherche documentaire : architecture, sécurité et ROI pour organisations.
Le fine-tuning est un ajustement ciblé d’un modèle existant sur des données d’exemple, afin d’améliorer certains comportements : style, format, suivi d’instructions, terminologie métier ou classification. Des variantes comme LoRA (Low-Rank Adaptation) et QLoRA (LoRA avec quantification) réduisent le coût en n’ajustant qu’une petite partie des poids du modèle, souvent avec un matériel plus accessible. Cela peut être pertinent quand : 1) le modèle ne respecte pas votre format même avec de bons prompts, 2) vous devez réduire la longueur des prompts pour des raisons de latence ou de coût, 3) vous cherchez à améliorer sa robustesse sur des cas récurrents. En revanche, le fine-tuning n’efface pas les risques liés aux données et ne résout pas un manque de sources à jour. Voir : Fine-tuning LLM : choisir RAG, LoRA ou QLoRA selon l’usage et, pour comprendre la chaîne complète, Entraînement LLM : étapes clés du prétraining au post-training.
Pour décider, utilisez des ordres de grandeur indicatifs, très variables selon le périmètre et les contraintes. 1) Prompting : quelques jours, peu de données, coût faible, mais performances parfois instables selon les cas. 2) RAG : 2 à 6 semaines pour un pilote robuste (indexation, découpage des documents, droits d’accès, monitoring), besoin d’un corpus propre, coût variable mais souvent maîtrisable car pas de réentraînement. 3) Fine-tuning : 4 à 12 semaines selon la qualité des données et les exigences de sécurité, besoin souvent de centaines à milliers d’exemples bien labellisés, coûts plus élevés (infrastructure, MLOps, validation). La métrique qui tranche n’est pas « ça a l’air bien », mais la performance sur un jeu de tests représentatif et la capacité à expliquer « d’où vient » la réponse.
Pour rendre ce choix plus concret, voici une grille synthétique (à adapter) :
| Approche | Quand ça marche bien | Pré-requis souvent oubliés | Risque typique à contrôler |
|---|---|---|---|
| Prompting + gabarits | Questions répétitives, format de réponse stable (mail, résumé, check-list) | Règles de réponse écrites, exemples de « bonne réponse » | Variabilité : réponse correcte 8 fois sur 10 mais instable sur les cas limites |
| RAG | Réponses qui doivent citer des procédures, contrats ou FAQ à jour | Qualité documentaire, découpage cohérent, contrôle d’accès au niveau document/fragment | Fuite via de mauvaises ACL, ou réponses non « groundées » malgré des sources |
| Fine-tuning | Format strict, classification, ton homogène, jargon métier très spécifique | Dataset propre, politique de labellisation, évaluation robuste | Sur-apprentissage, dérive après mises à jour, difficulté d’audit des exemples |
Enfin, gardez en tête un point « Europe-ready » : si votre cas d’usage touche à des décisions sensibles (RH, crédit, assurance, santé, services publics), vous devrez souvent renforcer la traçabilité, la documentation et les contrôles. En complément du RGPD, le cadre européen sur l’IA (AI Act) formalise des exigences selon le niveau de risque : Règlement européen sur l’intelligence artificielle (AI Act). Sans transformer votre projet en exercice juridique, l’intérêt pratique est de cadrer tôt : quel est le niveau de risque, quels contrôles sont attendus, quelles preuves il faudra produire.
Mesurer ce qui marche : jeux de test, évaluations et sécurité applicative
Une méthodologie « du diagnostic au déploiement sécurisé » tient ou s’effondre sur un point : l’évaluation. Un assistant peut sembler convaincant en démo et échouer en production sur des exceptions, des formulations inattendues ou des données non à jour. Il faut donc traiter l’IA comme un produit : objectifs, tests, itérations et critères de passage de jalons.
Construisez d’abord un jeu d’évaluation (offline) qui reflète vos cas réels. Incluez au minimum : 1) des questions fréquentes, 2) des questions rares mais risquées (juridique, sécurité, santé), 3) des demandes ambiguës où la bonne réponse est de poser une question de clarification, 4) des cas où la bonne réponse est « je ne sais pas ». Ajoutez des réponses de référence quand c’est possible, ou au moins des critères de notation (exactitude, complétude, respect du ton, citations de sources). C’est ce jeu qui vous permet de comparer prompting, RAG et fine-tuning sans débat subjectif.
Un détail qui fait gagner du temps : définissez une échelle de notation simple (0/1/2 par critère) et limitez-vous à 4–6 critères. Exemple : Exactitude, Source citée, Actionnable (prochaine étape claire), Conforme (pas de données sensibles, pas d’instruction dangereuse), Bonne posture (clarifie si nécessaire). Cette discipline évite les « discussions de démo » et rend vos itérations mesurables.
Ensuite, définissez des métriques simples, mais non négociables. Qualité : taux de réponses correctes, taux de refus approprié, taux de citations de sources pertinentes, score de similarité avec la réponse attendue quand applicable. Performance : latence p95, coût par requête, taux d’erreur. Risque : présence de données sensibles en sortie, tentatives de contournement, robustesse aux attaques par prompt injection. Sur ce dernier point, une ressource utile est l’OWASP Top 10 for LLM Applications, qui documente des catégories comme la prompt injection et la fuite de données.
Enfin, validez en conditions réelles avec une évaluation « online » progressive. Déployez d’abord à un groupe pilote, instrumentez les retours (boutons utile/pas utile, raisons, escalade) et surveillez les dérives. Un bon signal est la baisse mesurée du temps de traitement ou l’augmentation du taux de résolution au premier contact, mais uniquement si les équipes confirment que la charge de relecture ne compense pas les gains. Le but n’est pas de « faire parler un modèle », mais de réduire un coût, un délai ou un risque, tout en restant conforme.
Pour éviter un faux sentiment de sécurité, prévoyez aussi des tests de « robustesse » non fonctionnels : variations d’orthographe, questions tronquées, mélange de langues (cas fréquent dans des organisations multi-sites) et demandes hors périmètre. Un bon assistant d’entreprise n’est pas seulement bon quand on lui parle « proprement » : il doit rester prévisible quand l’entrée est imparfaite.
Industrialiser : gouvernance, MLOps et audits fournisseurs
Quand le pilote fonctionne, la difficulté change de nature. On passe d’un problème de « réponse » à un problème de cycle de vie : versions, droits, qualité des sources, incidents, auditabilité. Une IA d’entreprise déployée sans gouvernance devient rapidement un empilement fragile : documents non tracés, prompts modifiés sans revue, modèles mis à jour sans évaluation et logs impossibles à exploiter.
Mettez en place une gouvernance minimale dès l’industrialisation : registre de modèles et de prompts, responsabilité claire (owner métier, owner data, owner sécurité), règles de validation et critères de mise en production. L’objectif est de savoir répondre à tout moment : quel modèle est utilisé, avec quelles données, pour quel usage et avec quels contrôles. Pour une démarche structurée : Gouvernance de l’IA : registre de modèles, audits et cycle de vie.
Sur le volet fournisseurs (API, hébergement, outils d’annotation, prestataires), évitez le « shadow AI ». Exigez un dossier de sécurité et de conformité : localisation et isolation des données, conditions d’utilisation des données (notamment leur réutilisation pour l’entraînement), mécanismes de suppression, gestion des clés, journaux, sous-traitants. Une check-list opérationnelle aide à standardiser ce travail : Audit fournisseurs : check-list en 8 étapes pour sécuriser la conformité.
Côté MLOps, les points non optionnels sont connus mais souvent sous-estimés. 1) Versionner le modèle, les prompts et les jeux de test. 2) Rejouer les évaluations à chaque changement (documents, configuration de recherche, règles de filtrage). 3) Superviser en production : latence, coût, taux d’erreur, dérives de distribution, incidents de sécurité. 4) Gérer les accès finement, surtout en RAG : un assistant ne doit jamais exposer un document que l’utilisateur n’a pas le droit de lire. Ce contrôle passe par l’indexation avec métadonnées d’ACL et un filtrage strict à la requête.
Ajoutez un principe de gouvernance qui évite des incidents : aucun changement “silencieux”. Toute modification (nouvelle source indexée, règle de filtrage, prompt système, modèle) doit déclencher : (a) un identifiant de version, (b) une exécution du jeu de tests, (c) une revue rapide par la sécurité ou l’owner métier si le périmètre de données change. En pratique, cela ressemble plus à du contrôle qualité qu’à de la « data science », mais c’est ce qui rend l’IA exploitable à l’échelle.
Déployer de façon sécurisée : garde-fous, données sensibles et exploitation
Le déploiement sécurisé d’une IA d’entreprise combine des mesures techniques et opérationnelles. Techniquement, on protège l’interface (authentification, autorisation, quotas), on limite l’exposition (réduction des données envoyées au modèle) et on sécurise la chaîne (chiffrement en transit et au repos, gestion des secrets, segmentation réseau). Opérationnellement, on prépare l’exploitation : support, gestion d’incidents, processus de mise à jour et de rollback.
Les garde-fous doivent être explicites et testés. Exemples : 1) Règles de réponse : citer les sources, refuser quand la source manque, demander une clarification si la demande est ambiguë. 2) Contrôles de sortie : détection de données personnelles ou confidentielles avant affichage, blocage ou masquage. 3) Modes dégradés : si la recherche documentaire échoue, l’assistant doit basculer vers une réponse prudente ou orienter vers un canal humain. Dans beaucoup d’organisations, un mode « human-in-the-loop » au démarrage réduit le risque : l’IA propose, un agent valide.
Sur les données sensibles, gardez une règle simple : si vous ne pouvez pas justifier la présence d’une donnée dans la requête ou dans l’index, supprimez-la. Pseudonymiser ne suffit pas toujours si la réidentification est possible par croisement. Documentez vos décisions (quelles données sont exclues, pourquoi et comment) et prévoyez un contrôle continu. Pour des recommandations pratiques côté autorités françaises, les ressources de la CNIL sur l’intelligence artificielle et la protection des données constituent une base utile.
Si vous êtes dans un secteur fortement régulé (santé, banque/assurance, secteur public), explicitez aussi où se situent vos « lignes rouges » opérationnelles : quels types de documents ne doivent jamais être indexés, quelles catégories d’utilisateurs ne doivent pas avoir accès à certaines informations et quelles actions doivent rester strictement humaines (validation d’un document contractuel, décision RH, etc.). Cette clarté réduit les débats tardifs et accélère le passage en production.
Enfin, préparez l’exploitation comme pour un service critique. Définissez un SLA interne (disponibilité, latence), une politique de logs (contenu, durée de conservation, accès) et un playbook d’incident (fuite de données, réponse dangereuse, prompt injection réussie). Le déploiement « sécurisé » ne signifie pas « sans risque », mais « avec des risques identifiés, testés, surveillés et réduits ». La maturité se voit quand vous pouvez prouver, chiffres à l’appui, que les contrôles fonctionnent et que la qualité reste stable après les mises à jour.
Première action concrète : lancer un diagnostic en 2 heures avec 10 cas réels
Bloquez un créneau de 2 heures avec un binôme métier et un binôme technique (data ou dev), ainsi qu’un référent sécurité ou DPO si des données personnelles sont probables. L’objectif n’est pas de décider d’une technologie, mais d’écrire la fiche de cadrage et de collecter la matière minimale pour tester.
Pour que l’atelier reste concret, vous pouvez suivre un déroulé simple (sans surcharger) : 20 minutes pour cadrer le périmètre, 50 minutes pour lister et préciser les 10 cas, 30 minutes pour identifier les sources et leurs propriétaires, 20 minutes pour définir la grille de succès et les « non négociables » (sécurité, conformité, traçabilité).
Pendant l’atelier, produisez trois livrables. 1) Une liste de 10 questions réelles (celles qui coûtent du temps, celles qui créent des risques). 2) Les sources attendues pour y répondre (procédures, contrats, base de connaissances) avec un propriétaire identifié par source. 3) Une grille de succès avec 5 critères notés (ex. exactitude, citation de source, latence, absence de données sensibles, taux de refus approprié).
Si vous voulez rendre la grille immédiatement utilisable, formalisez-la en tableau (à cocher lors des tests) :
| Critère | Seuil “OK pour pilote” (exemple) | Commentaire |
|---|---|---|
| Exactitude métier | ≥ 8/10 cas corrects | Tolérance zéro sur les cas à risque élevé |
| Sources citées | ≥ 7/10 avec citation exploitable | Lien + extrait, pas « selon la doc » |
| Refus approprié | Refus sur cas hors périmètre | Refus justifié + orientation |
| Données sensibles en sortie | 0 incident | Contrôle automatique + revue humaine au début |
| Latence p95 | Compatible avec l’usage | Ex. support interne : quelques secondes |
Une fois ces éléments posés, vous avez un point de départ utile : comparer rapidement un prototype « prompting + règles » à un prototype RAG sur un périmètre contrôlé, tout en sachant comment mesurer. Tant que vous n’obtenez pas un gain mesurable sur ces 10 cas, résistez à la tentation d’entraîner un modèle. Dans la majorité des projets, c’est l’accès aux bonnes sources, la qualité des documents et la gouvernance qui font la différence, bien avant le fine-tuning.