Table des matières :
- Pourquoi la classification des données doit être liée à une cartographie des flux (application et réseau)
- Définir une taxonomie exploitable : classes, niveaux, et règles de traitement
- Cartographier les flux au niveau applicatif : où naissent les données et comment elles se transforment
- Cartographier les flux au niveau réseau : observer, attribuer, et qualifier sans tout inspecter
- Relier classification et flux : contrôles concrets (DLP, segmentation, IAM) et usage IA sans fuite
- Mesurer l’efficacité, estimer les coûts, et déployer par itérations (sans chantier interminable)
Pourquoi la classification des données doit être liée à une cartographie des flux (application et réseau)
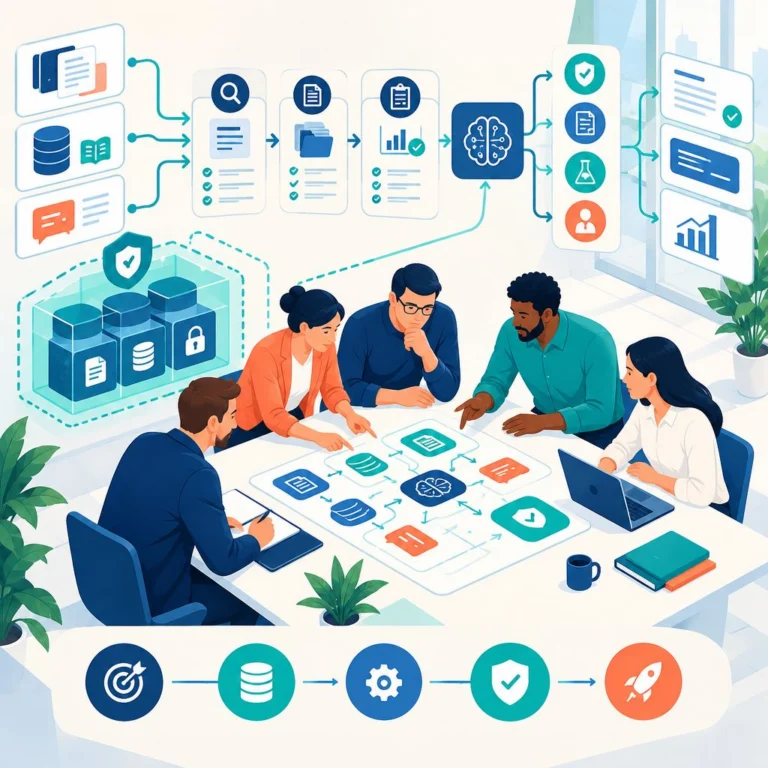
Classer les données sans comprendre où elles circulent revient à étiqueter des cartons sans savoir dans quels camions ils partent. En entreprise, les données sensibles ne restent presque jamais « dans une base » : elles transitent par des API, des ETL, des fichiers exportés, des outils SaaS, des postes utilisateurs, des VPN, des tunnels inter-sites et des services cloud. La classification des données prend tout son sens quand elle sert une cartographie des flux sensibles par application et réseau, c’est-à-dire une vue factuelle de qui émet, qui reçoit, quel type de données, par quel canal, et avec quels contrôles.
Le besoin métier est simple : réduire le risque et accélérer les projets. Côté risque, on veut éviter les fuites (exfiltration, mauvais partage, mauvaise configuration), les non conformités (RGPD, exigences contractuelles, audits) et les interruptions (ransomware, suppression accidentelle). Côté delivery, on veut arrêter de bloquer des projets par prudence excessive, faute de savoir précisément quelles données sont concernées. Une cartographie de flux bien tenue aide à arbitrer : quelles données peuvent sortir, lesquelles doivent rester en réseau interne, lesquelles doivent être chiffrées de bout en bout, lesquelles nécessitent des contrôles d’accès plus stricts.
Cette approche devient encore plus concrète dès qu’un projet « IA interne » arrive. Beaucoup d’équipes pensent immédiatement à entraîner un modèle. Or, dans la majorité des cas, l’enjeu n’est pas d’entraîner, mais de donner au modèle existant les bons documents et les bonnes règles d’accès. On parle souvent de RAG (Retrieval-Augmented Generation) : le modèle génère en s’appuyant sur des documents récupérés dans votre base documentaire. Sans classification et cartographie des flux, un RAG peut récupérer un document trop sensible, ou au contraire passer à côté d’une information utile parce qu’elle est stockée dans un endroit non référencé.
Deux points pratiques sont souvent sous-estimés dans les organisations françaises et européennes :
- La localisation et les transferts : dès qu’un flux sort de l’EEE (ou est opéré par un sous-traitant hors EEE), il faut être capable de dire quelles données sortent, par quel chemin et avec quelles garanties. La cartographie des flux devient un artefact utile pour les analyses contractuelles et les évaluations de risque.
- La traçabilité “auditable” : un audit (interne, client, ou régulateur) ne demande pas uniquement une politique, mais des preuves (ex. journaux, règles réseau, revues d’accès). La cartographie, si elle est tenue à jour, fait le lien entre intention et réalité.
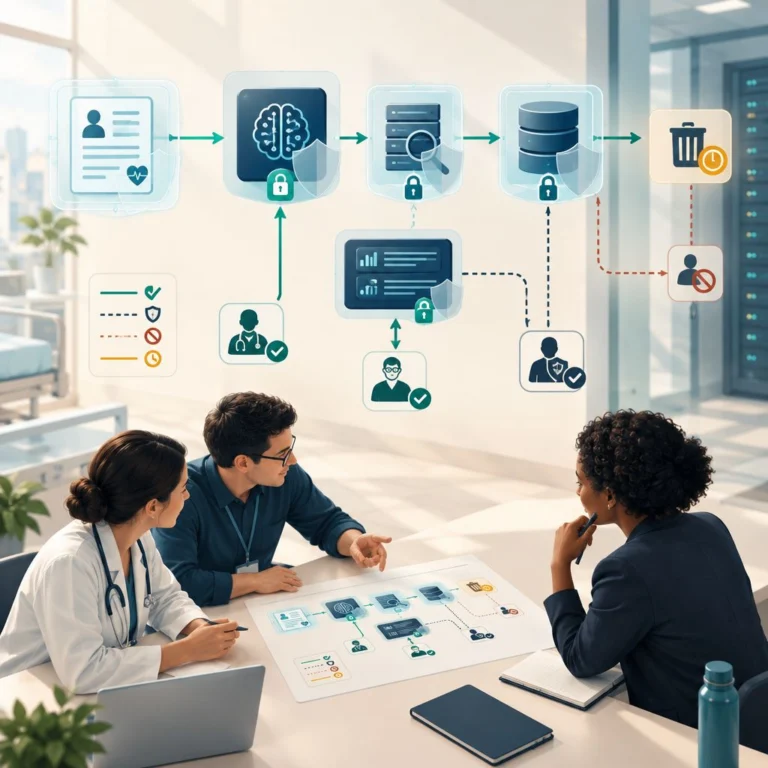
Pour cadrer immédiatement ce que vous cherchez à représenter, une cartographie exploitable décrit généralement chaque flux avec ces attributs minimaux : source (application/compte de service), destination, canal (API, SFTP, message queue, partage, web), données (objets et niveau de classification), chiffrement en transit, authentification/autorisation, rétention, responsable (owner).
« The objective of security categorization is to determine the potential impact on an organization should certain events occur which jeopardize the information… » — NIST SP 800-60 Vol. 1 Rev. 1, Guide for Mapping Types of Information and Information Systems to Security Categories (NIST SP 800-60 (pdf))
Définir une taxonomie exploitable : classes, niveaux, et règles de traitement
Une classification utile n’est pas une liste infinie de catégories. C’est un langage commun entre métiers, sécurité, data et IT, qui permet de prendre des décisions répétables. La plupart des organisations commencent avec 4 à 6 niveaux, par exemple : Public, Interne, Confidentiel, Très sensible. À ces niveaux s’ajoutent des types (ou familles) : données personnelles, données financières, secrets industriels, code source, contrats, données de santé, journaux techniques, etc. L’erreur fréquente est de confondre type et niveau : une donnée personnelle peut être « Interne » (annuaire interne) ou « Très sensible » (données RH détaillées).
Pour éviter le flou, construisez une grille simple basée sur l’impact. Un modèle pratique consiste à décliner l’impact sur confidentialité, intégrité, disponibilité (CIA). Par exemple, une table « IBAN + historique de virements » aura un impact fort sur la confidentialité et l’intégrité, et un impact modéré sur la disponibilité. Cette lecture aide à choisir des contrôles adaptés : chiffrement, contrôle d’accès, journalisation, segmentation, sauvegardes immuables, etc. Ce n’est pas un exercice théorique : l’impact détermine où la donnée peut transiter et quels flux sont acceptables.
Pour rendre la taxonomie immédiatement actionnable, ajoutez (dès le départ) des exemples et des contrôles “minimum” par niveau. Exemple de grille synthétique (à adapter à vos contraintes et obligations) :
| Niveau | Exemples fréquents | Contrôles minimaux (transit/accès) |
|---|---|---|
| Public | Communiqués, pages web | Aucun contrôle spécifique, intégrité surveillée |
| Interne | Procédures internes, organigramme | Authentification, TLS, gestion des droits |
| Confidentiel | Contrats, factures détaillées, données clients courantes | Principe du « besoin de savoir », journalisation, egress contrôlé, partage externe encadré |
| Très sensible | Données RH détaillées, secrets industriels, clés/secrets | Environnements dédiés, egress très restreint, chiffrement fort, supervision renforcée |
Enfin, associez à chaque classe une règle de traitement. Exemple :
- Public : partage autorisé, pas de restriction réseau.
- Interne : accès authentifié, transit chiffré (TLS), stockage chiffré recommandé.
- Confidentiel : accès sur besoin d’en connaître, journalisation renforcée, partage externe interdit par défaut, egress contrôlé.
- Très sensible : environnements dédiés, egress très limité, chiffrement fort, rotation de clés, restriction d’outils (pas d’export CSV sans justification), rétention minimisée.
Deux règles simples évitent beaucoup de débats interminables :
- En cas de doute, classer “au-dessus” (et ouvrir une exception documentée si nécessaire). L’exception doit préciser responsable, durée, mesures compensatoires (ex. chiffrement + restriction IP + logs).
- La donnée dérivée hérite du niveau le plus élevé des sources, sauf si vous pouvez démontrer une anonymisation réelle (ce qui est plus exigeant qu’une pseudonymisation).
Ces règles deviennent la base de la cartographie : chaque flux observé peut être évalué « conforme / à corriger / à justifier ». Et pour les données personnelles, rappelez le principe de minimisation comme garde-fou opérationnel.
« Les données à caractère personnel doivent être… adéquates, pertinentes et limitées à ce qui est nécessaire au regard des finalités » — RGPD, article 5(1)(c)
Cartographier les flux au niveau applicatif : où naissent les données et comment elles se transforment
Cartographier « par application » signifie documenter les systèmes producteurs, les consommateurs, et les transformations. Concrètement, pour chaque application métier (CRM, ticketing, ERP, outil RH, data warehouse), on cherche : les sources (formulaires, imports), les stockages (bases, objets, fichiers), les sorties (exports, API, webhooks), et les traitements (ETL/ELT, jobs, scripts). C’est la partie la plus riche, car elle donne du sens : un flux réseau n’est qu’un paquet IP tant qu’on ne sait pas qu’il s’agit d’un export de facturation.
La méthode la plus robuste combine ateliers et preuves techniques. Les ateliers (métier, IT, data, sécurité) permettent de lister les objets de données : « compte client », « contrat », « pièce jointe », « log de connexion ». Puis, on vérifie avec des éléments factuels : schémas de bases, catalogues de données, configurations d’ETL, définitions d’API, et inventaires de buckets ou partages. Si vous avez déjà un outil de data catalog ou de data lineage, exploitez-le. Sinon, des standards comme OpenLineage peuvent structurer progressivement la traçabilité des transformations.
Pour éviter une cartographie trop “théorique”, imposez un format de description identique pour chaque échange applicatif. Par exemple, sur une seule page (ou une fiche), capturez :
- Objet(s) de données (ex. Compte client, Ticket support, Bulletin de paie)
- Champs sensibles présents (ex. email, IBAN, NIR si applicable, pièces jointes)
- Type de transformation (filtrage, agrégation, enrichissement, pseudonymisation)
- Mode d’échange (API/CSV/SFTP/message queue) et fréquence (temps réel, nightly batch)
- Identité technique (compte de service, clé API, certificat) et responsable
- Rétention côté cible (durée, purge, archivage)
Niveau technique, prévoyez trois techniques complémentaires :
- Discovery de données : scan de schémas (noms de colonnes), expressions régulières (IBAN, emails), et détection assistée (modèles de classification de champs). Attention : le scan peut générer des faux positifs et doit rester sous contrôle (accès restreint, logs, périmètre défini).
- Lineage : rattacher les tables cibles aux tables sources, et les jobs aux datasets. Très utile pour savoir qu’une colonne sensible se retrouve dans une table « marts » puis dans un export BI.
- Cartographie des échanges applicatifs : API calls, files drops, messages (queues), webhooks. Pour chaque échange, notez format, fréquence, taille, mécanisme d’authentification, et méthode de chiffrement.
Un exemple réaliste : une ETI industrielle découvre que son outil de support exporte chaque nuit des tickets complets (avec pièces jointes) vers un espace partagé utilisé par un prestataire. Sur le papier, « support » était classé Interne. L’analyse applicative révèle des pièces jointes contenant des plans et numéros de série, donc Confidentiel voire Très sensible. Résultat : l’action prioritaire n’est pas « mieux former les équipes » mais changer le flux (suppression des pièces jointes, dépôt chiffré, durée de rétention, comptes de service dédiés, revue d’accès).
Une variante très fréquente en environnement “data” : une équipe crée un export “temporaire” pour une analyse (CSV déposé sur un partage ou un bucket), puis ce flux devient quasi permanent. La cartographie applicative permet de repérer ces “raccourcis” et de les industrialiser (ou de les supprimer) : contrat de données, contrôle d’accès, expiration automatique, et règles de nommage/tagging qui reflètent la classification.
Cartographier les flux au niveau réseau : observer, attribuer, et qualifier sans tout inspecter
La cartographie réseau répond à une question simple : quels systèmes parlent à quels systèmes, à quelle fréquence, et vers quelles destinations (internes, cloud, Internet). Elle complète la cartographie applicative car elle révèle les flux oubliés : scripts historiques, synchronisations SaaS, tunnels, services « shadow IT », et communications est-ouest entre microservices. Sur un SI hybride, cette visibilité est souvent le point de départ le plus rapide.
Techniquement, privilégiez d’abord les données de flux plutôt que l’inspection complète des contenus. Les sources classiques sont :
- NetFlow/IPFIX sur équipements réseau.
- Logs de pare-feu et de proxies.
- VPC Flow Logs côté cloud (AWS, Azure, GCP) pour tracer les flux au niveau réseau virtuel.
- Télémétrie Kubernetes via eBPF (extended Berkeley Packet Filter) qui observe les connexions au niveau noyau avec un coût raisonnable, utile pour attribuer un flux à un pod, un namespace, une identité de service.
Ces signaux donnent les 80 % : top talkers, destinations inconnues, ports inattendus, volumes anormaux, et dépendances non documentées.
La difficulté est l’attribution. Un flux sortant vers 443 peut être une API de paiement, un stockage, ou un tunnel. Pour attribuer sans casser le chiffrement TLS, combinez :
- Résolution DNS (log du résolveur interne, query name) pour relier IP et domaine.
- Inventaire des actifs (CMDB, tags cloud, labels Kubernetes) pour relier IP et application.
- Métadonnées TLS quand disponibles (SNI, certificats vus au proxy) avec prudence sur la conservation.
L’inspection de contenu (DPI) n’est pas toujours nécessaire et peut être coûteuse et sensible. On la réserve aux segments critiques ou aux cas d’enquête.
Deux points “terrain” améliorent nettement la qualité de la cartographie réseau :
- Normaliser l’identité des workloads : si vos instances/pods n’ont pas de tags/labels cohérents (app, équipe, environnement, responsable), l’attribution restera approximative. Fixer une convention de tagging est souvent un “quick win”.
- Définir une fenêtre de collecte représentative : une semaine complète couvre les batchs, mais certains flux sont mensuels (paie, clôture comptable). Prévoir une collecte plus longue sur les périmètres critiques évite de conclure trop vite à l’absence de flux.
À noter, en contexte RGPD, certains journaux (ex. adresses IP, identifiants) peuvent être considérés comme des données à caractère personnel selon les cas. Cela ne bloque pas la cartographie, mais impose de cadrer finalité, durée de conservation, accès et sécurité des logs. Une ressource utile côté France : le Guide de la sécurité des données personnelles (CNIL).
Un cas courant : après activation des VPC Flow Logs, une équipe identifie que, sur un sous‑réseau applicatif, un pourcentage important des flux sortants vers des domaines non présents dans l’inventaire — souvent entre 25 % et 40 % — nécessite un tri. Après analyse, on retrouve un mélange de mises à jour système, d’APM légitime, et de connecteurs SaaS installés « pour tester ». La cartographie réseau permet alors de poser une règle simple : tout flux sortant doit être rattaché à une application, un responsable, et une justification, sinon il est bloqué ou mis en quarantaine. Ce genre de règle, appliquée progressivement, réduit le bruit et accélère les audits.
Relier classification et flux : contrôles concrets (DLP, segmentation, IAM) et usage IA sans fuite
Une fois que vous avez une taxonomie et une cartographie de flux, l’objectif est de transformer cela en décisions opérationnelles. La démarche la plus efficace consiste à définir quelques politiques alignées sur les classes. Exemple : « Confidentiel ne sort pas sur Internet sans proxy, journalisation, et chiffrement », ou « Très sensible ne transite qu’entre environnements tagués restricted ». Ces règles se traduisent ensuite en contrôles : filtrage egress, segmentation réseau, règles de pare-feu, politiques de service mesh, contrôle des comptes de service, et gouvernance des clés.
Une manière simple de relier flux et contrôles consiste à formaliser une matrice “classe × canal” (même minimale), par exemple :
| Canal de sortie | Interne | Confidentiel | Très sensible |
|---|---|---|---|
| API vers SaaS approuvé | Autorisé (TLS + auth) | Autorisé avec justification + logs + egress contrôlé | En principe interdit, exception formelle uniquement |
| Export fichier (SFTP/partage) | Autorisé avec rétention | Autorisé si chiffrement + comptes dédiés + purge | Très restreint, préférer dépôt chiffré et éphémère |
| Autorisé | À limiter, DLP ciblée | À proscrire sauf canal dédié et très encadré |
Pour la prévention des fuites, le terme DLP (Data Loss Prevention) recouvre des contrôles capables de détecter ou bloquer la sortie de données sensibles. Sans entrer dans des comparatifs de solutions, retenez le principe : une DLP devient pertinente quand elle sait quoi chercher (classification), et où regarder (flux). Dans les faits, beaucoup d’organisations obtiennent de bons résultats avec une DLP « ciblée » : quelques règles robustes (ex. identifiants, IBAN, exports massifs), activées sur les canaux majeurs (email, web, stockage partagé), plutôt qu’une surveillance totale qui génère trop de faux positifs.
Ne sous-estimez pas l’IAM dans la cartographie : beaucoup de fuites sont des “fuites par droit excessif”. Une cartographie de flux exploitable précise aussi :
- qui accède (rôle, groupe, compte de service),
- avec quelle preuve (MFA, certificat, token),
- et avec quel périmètre (scopes API, droits sur bucket, ACL sur partage).
Côté IA, la classification et la cartographie changent votre stratégie. Avant d’envisager du fine-tuning (ré-entraîner un modèle sur vos données), essayez de résoudre le besoin avec un RAG. Le RAG s’appuie sur des embeddings (représentations vectorielles d’un texte) pour retrouver les passages pertinents. L’enjeu principal n’est pas l’algorithme : c’est la sélection des documents autorisés et leur fraîcheur. Une cartographie des données et des flux vous permet de construire des filtres :
- sources autorisées par classe (ex. uniquement Interne et certains Confidentiel),
- filtres par équipe (contrôles d’accès identiques à ceux des outils d’origine),
- exclusion des pièces jointes ou champs très sensibles.
Un garde-fou simple et efficace sur un RAG : appliquer les ACL au moment de la récupération, pas uniquement à l’indexation. Sinon, vous risquez d’indexer un corpus large puis de “fuir” des passages via une requête d’un utilisateur moins privilégié. Dans les environnements où des documents “Confidentiel” cohabitent avec “Très sensible”, il est souvent plus sûr de séparer les espaces (index/stockage) par classe ou par domaine.
Si un fine-tuning devient nécessaire, des techniques comme LoRA (Low-Rank Adaptation, une méthode d’adaptation légère qui évite de ré-entraîner tout le modèle) peuvent réduire le coût. Mais la règle de base reste : données sensibles à traiter avant tout entraînement (pseudonymisation, anonymisation quand possible, minimisation, segmentation des environnements, traçabilité des accès). En pratique, le « bon » résultat se mesure autant en réduction de risque qu’en gain d’utilité.
Mesurer l’efficacité, estimer les coûts, et déployer par itérations (sans chantier interminable)
La cartographie des flux sensibles n’a pas besoin d’être parfaite pour être utile, mais elle doit être mesurable. Définissez des indicateurs simples :
- Taux de flux sortants non attribués (objectif : le réduire itération après itération).
- Nombre d’applications avec responsable et classification validés.
- Couverture de classification : % de datasets critiques classés.
- Temps moyen de qualification d’un nouveau flux (processus de changement).
- Incidents DLP : volume, faux positifs, et temps de résolution.
Ajoutez un indicateur de “fraîcheur” pour éviter la cartographie musée : % de flux revus au cours des 90 derniers jours (ou à chaque changement majeur). Cette simple mesure force l’intégration au cycle de vie (projets, changements, MCO).
Ces métriques évitent l’écueil classique : une cartographie qui se fige dans un fichier et ne correspond plus à la réalité.
En ordre de grandeur, un premier périmètre raisonnable (10 à 20 applications, un environnement cloud, un site on‑prem) se déroule souvent en 4 à 8 semaines, selon la maturité des inventaires et l’accès aux logs. Les coûts sont principalement du temps humain : ateliers (métier et IT), cadrage sécurité, mise en place de télémétrie, et nettoyage de l’inventaire. L’automatisation (scan, tagging, collecte de flow logs) accélère, mais ne remplace pas la validation : une classification erronée est parfois pire que l’absence de classification, car elle donne une fausse confiance.
Pour piloter, vous pouvez transformer l’effort en backlog très concret, par exemple (exprimé en livrables vérifiables) :
- 1 fiche “application” par système critique (objets de données + niveau + responsables)
- 1 liste “flux sortants observés” (avec attribution) par zone réseau
- 10 décisions de remédiation (bloquer / corriger / accepter avec justification)
- 1 règle de contrôle ajoutée (ex. egress proxy obligatoire pour une classe de données)
Déployez par itérations avec une règle : chaque itération doit produire une amélioration contrôlable. Une séquence efficace ressemble à ceci :
- Choisir 1 domaine métier prioritaire (ex. service client, facturation, RH) et 3 à 5 applications clés.
- Définir la taxonomie minimale et les règles de traitement associées.
- Activer la collecte de flux réseau (pare-feu, VPC Flow Logs, DNS logs) et l’attribution (tags, CMDB).
- Identifier 10 flux à risque ou non attribués et décider : accepter, corriger, ou bloquer.
- Mettre à jour la documentation et intégrer la vérification dans le processus de changement (nouveau connecteur, nouvel export, nouveau bucket).
La première étape concrète à réaliser cette semaine : sélectionnez une application critique (CRM ou ticketing), listez 10 objets de données qu’elle manipule, associez à chacun un niveau de classification, puis activez la collecte des flux réseau sortants de cette application (logs de pare-feu ou flow logs cloud) pour produire une liste de destinations réelles. À partir de cette liste, vous aurez immédiatement 2 ou 3 flux à corriger et une base solide pour étendre la démarche.