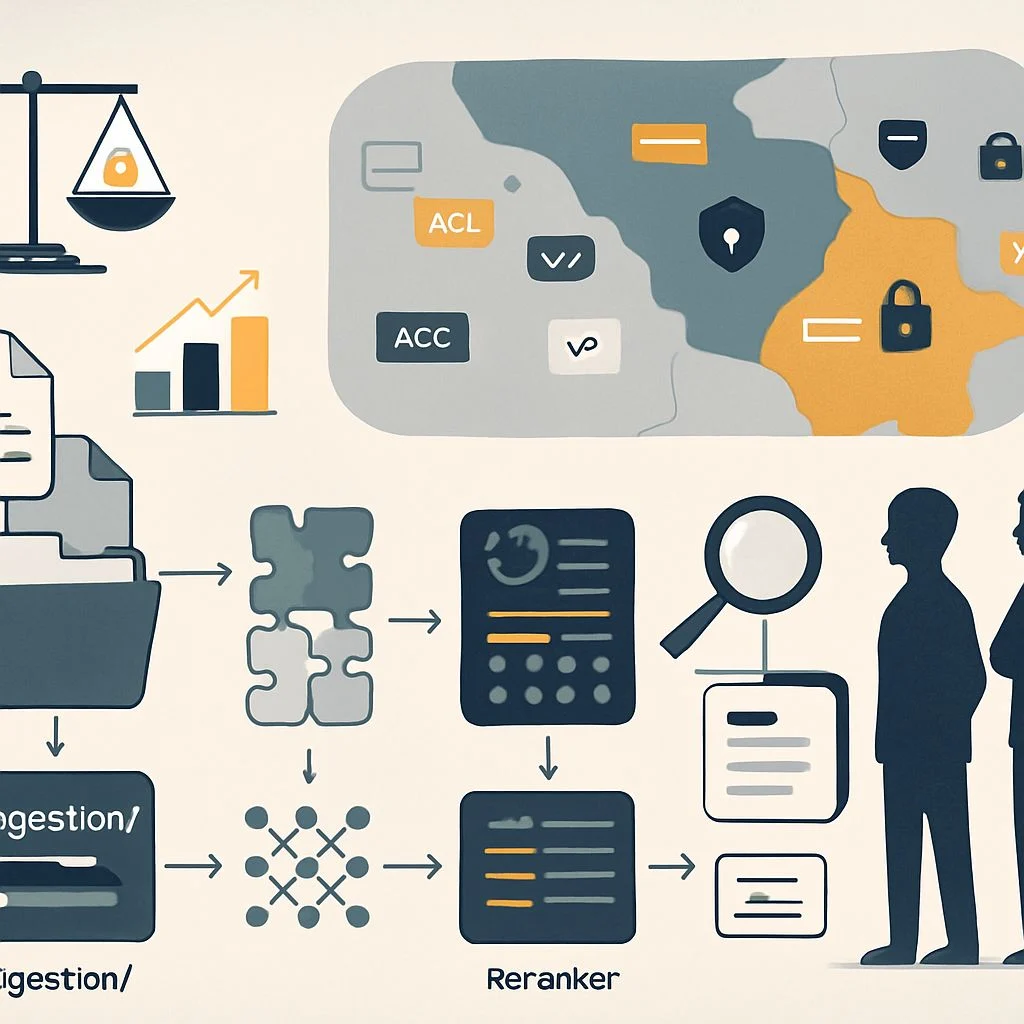
Table des matières :
- RAG ou entraînement : choisir la bonne approche pour la recherche documentaire
- Architecture RAG de bout en bout : ce qui se passe réellement sous le capot
- Recherche documentaire qui tient en production : chunking, métadonnées, mises à jour
- Mesurer la qualité d’un RAG : métriques, tests, et gestion des erreurs
- Sécurité et conformité : protéger les documents, contrôler l’exfiltration, auditer
- ROI du RAG : modèle de coûts, délais réalistes, et indicateurs de valeur
- Mise en œuvre en 6 semaines : livrables, garde-fous, et première étape concrète
RAG ou entraînement : choisir la bonne approche pour la recherche documentaire
Quand une organisation dit vouloir « une IA qui connaît nos documents », la tentation est d’entraîner un modèle. Dans la majorité des cas, ce n’est pas nécessaire. La bonne question est métier : veut-on répondre à partir de documents internes (procédures, contrats, tickets, base de connaissances), ou veut-on changer le style et le comportement du modèle (ton, format, jargon, raisonnement) sur tous les sujets, y compris hors documents ? Le RAG (Retrieval-Augmented Generation) vise le premier besoin. Il connecte un LLM existant à vos sources de vérité, plutôt que de tenter de « mémoriser » ces contenus.
Le RAG est particulièrement adapté quand le contenu évolue souvent (politiques RH, fiches produit, règles de conformité), quand vous devez citer une source, ou quand les données sont trop sensibles pour être copiées dans un jeu d’entraînement. Il couvre aussi le cas où les erreurs coûtent cher : juridique, maintenance industrielle, support niveau 2. À l’inverse, le fine-tuning (réentraînement supervisé d’un modèle sur vos exemples) devient pertinent si vous avez beaucoup d’exemples de sorties attendues et si le problème est surtout un problème de format ou de comportement. Pour trancher de façon structurée, vous pouvez vous appuyer sur l’article interne : Fine-tuning LLM : choisir RAG, LoRA ou QLoRA selon l’usage.
Un repère simple en atelier de cadrage : si votre équipe passe son temps à dire « l’IA n’a pas lu le document X » ou « elle invente parce qu’elle n’a pas l’info », le RAG est généralement la première étape. Si au contraire vous dites « elle a l’info mais elle ne répond pas comme nos experts » (structure, critères de décision, niveau de prudence, terminologie), alors un ajustement par prompt, puis éventuellement un fine-tuning, est à considérer. En pratique, beaucoup de projets réussis combinent : RAG pour la factualité et un léger post-training pour le style. Sur les étapes d’entraînement et leurs implications (données, coûts, risques), voir aussi Entraînement LLM : étapes clés du prétraining au post-training.
Pour éviter de décider « au feeling », un outil utile est une matrice de choix (à discuter avec métier + RSSI + data/IT) :
| Question de cadrage | Si la réponse est “oui” | Approche généralement la plus efficace |
|---|---|---|
| Avez-vous besoin de citer des passages exacts (audit, conformité, qualité) ? | Oui | RAG (avec citations, traçabilité) |
| Le corpus change chaque semaine (procédures, offres, tarifs, règles) ? | Oui | RAG (réindexation incrémentale) |
| Le problème est surtout « le modèle ne suit pas notre format / nos critères » ? | Oui | Prompting avancé, puis fine-tuning si nécessaire |
| Les réponses doivent rester correctes même si la donnée n’est pas dans le corpus | Oui | Fine-tuning / outils + règles métier (le RAG seul ne suffit pas) |
| Vos données internes sont sensibles (secret, PII) et vous voulez éviter la copie dans des datasets | Oui | RAG avec contrôles d’accès et minimisation |
Mini-scenario (réaliste en organisation) : une direction QHSE dispose de procédures de sécurité mises à jour trimestriellement. Un fine-tuning « figerait » un état ; il faudrait relancer un cycle d’entraînement et requalifier. Un RAG, lui, permet de publier la version N+1 et de la rendre disponible après réindexation, avec une réponse qui renvoie vers la procédure en vigueur (et sa date).
Enfin, côté SEO/usage réel : la requête n’est pas « IA » mais recherche documentaire. En pratique, un bon cadrage RAG commence par identifier les intentions de recherche internes (ex. “comment faire une demande X”, “quelle clause s’applique”, “quelle procédure selon le site/filiale”), car ce sont elles qui guideront le chunking, les filtres de métadonnées, et l’évaluation.
Architecture RAG de bout en bout : ce qui se passe réellement sous le capot
Un système RAG n’est pas « un chatbot + des PDF ». C’est une chaîne. D’abord l’ingestion documentaire : collecte des sources (GED, wiki, SharePoint, CRM, tickets, dossiers réseau), normalisation, extraction de texte, et enrichissement par métadonnées. Les PDF scannés demandent souvent de l’OCR. Les tableaux et schémas doivent parfois être convertis en texte structuré, sinon le modèle répond de façon vague. À ce stade, on décide aussi ce qui est exclu (données personnelles non nécessaires, secrets industriels, clauses contractuelles interdites de diffusion).
Ensuite viennent les embeddings. Un embedding est une représentation vectorielle dense d’un texte, conçue pour rapprocher en « distance » des textes de sens similaire. On découpe les documents en « chunks » (segments) avant de calculer les embeddings, car indexer des documents entiers dégrade la précision. Ces vecteurs sont stockés dans un index (souvent appelé base vectorielle) avec des métadonnées : source, date, langue, niveau de confidentialité, droits d’accès. La recherche fait alors un « nearest neighbors search » : on embed la question, on récupère les chunks les plus proches.
Enfin, la génération. Le LLM reçoit la question et les extraits retrouvés (le « contexte ») et produit une réponse. Les architectures robustes ajoutent souvent deux briques : un reranking (un second modèle qui re-trie les passages pour maximiser la pertinence) et un garde-fou de « grounding » (forcer la réponse à se baser sur les extraits, avec citations). Le papier fondateur popularisant cette idée le résume ainsi : « We introduce Retrieval-Augmented Generation (RAG) models where the parametric memory is a pre-trained seq2seq model and the non-parametric memory is a dense vector index » (Lewis et al., 2020, arXiv : https://arxiv.org/abs/2005.11401). Dans une organisation, l’enjeu n’est pas seulement d’implémenter ce schéma, mais de le rendre observable, sécurisé et rentable.
Deux précisions “terrain” qui évitent beaucoup de surprises :
- Une architecture RAG est aussi une architecture de données. Les questions “où sont les documents ? qui les possède ? qui a le droit ? quelle version est officielle ?” déterminent la qualité plus que le choix du LLM.
- La latence est un budget. Un parcours RAG typique en production additionne : temps de recherche (lexicale + vectorielle), temps de reranking, puis temps d’inférence LLM. Sans pilotage, la somme dépasse vite l’acceptable pour un usage support (où viser un p95 raisonnable est souvent plus important qu’un score moyen flatteur).
Côté contexte géographique (France/UE), la question d’architecture revient souvent à : où résident les données et les logs ? Même si le RAG n’“entraîne” pas, il traite des documents internes. Les décisions d’hébergement (UE vs hors UE), de rétention des logs, et de sous-traitance doivent donc être alignées avec vos contraintes (RGPD, clauses contractuelles clients, exigences sectorielles). L’important ici n’est pas d’ajouter de la complexité, mais de documenter clairement les flux : sources → pipeline → index → application → journaux.
Recherche documentaire qui tient en production : chunking, métadonnées, mises à jour
Le chunking est un choix d’architecture, pas un détail. Des chunks trop longs font perdre des informations dans la fenêtre de contexte et diluent la pertinence. Des chunks trop courts cassent les références (définitions, exceptions, étapes). En entreprise, on vise souvent des segments d’une à trois unités logiques : un paragraphe, une procédure, une clause. On ajoute parfois un chevauchement (overlap) pour conserver le fil. Le bon choix se valide par tests : questions réelles, non pas exemples artificiels.
Une règle pratique (à adapter à votre corpus) : si vos utilisateurs posent des questions du type « quelles conditions / exceptions s’appliquent ? », découper par clause ou par sous-section fonctionne mieux que “au nombre de caractères”. À l’inverse, pour une base de connaissances support, découper par “étapes de résolution” (symptôme → cause → action) donne souvent de meilleurs résultats que découper par page.
Les métadonnées et les filtres sont le deuxième pilier. Une recherche vectorielle pure peut ramener un passage « proche » mais d’un pays, d’une gamme produit ou d’une version obsolète. On gagne en précision en ajoutant des filtres stricts : langue, BU, région, version, date d’entrée en vigueur, statut brouillon, et surtout droits d’accès. Dans beaucoup d’organisations, la recherche est plus fiable quand elle devient hybride : un score lexical (type BM25) pour la précision sur les termes et un score vectoriel pour la sémantique. Le reranking final améliore encore le top 3, qui est souvent ce qui compte pour la réponse.
Checklist simple de métadonnées (souvent suffisante pour une V1 robuste) :
source_system(GED, wiki, ticketing…)document_id+document_url(pour la traçabilité et le clic)owner/ propriétaire métiereffective_date(date d’entrée en vigueur) +last_reviewedversion(ou hash du contenu)lang(FR/EN…) et éventuellementcountry/siteconfidentiality(public/interne/confidentiel…) + ACL (groupes/roles autorisés)status(draft/valid/obsolete)
La mise à jour est le troisième point qui fait échouer les POC. Un RAG utile doit gérer l’incrémental : nouveaux documents, suppression, expiration, changement de droits. Il faut une stratégie de réindexation (batch nocturne, streaming, ou hybride) et un mécanisme de traçabilité. Qui a indexé quoi, quand, avec quelle version du pipeline d’extraction. Sans cela, vous ne pourrez pas expliquer pourquoi une réponse cite une procédure remplacée. Cette discipline rejoint les pratiques de gouvernance décrites dans Gouvernance de l’IA : registre de modèles, audits et cycle de vie.
Un point souvent sous-estimé : la déduplication (mêmes PDF stockés à plusieurs endroits, versions quasi identiques, copier-coller dans des wikis). Sans mécanisme (hash de contenu, canonical URL, règles de priorité par source), votre retrieval va remonter des doublons, et le LLM “moyennera” des versions divergentes au lieu de choisir la bonne. En recherche documentaire d’entreprise, mieux vaut parfois moins de documents, mais mieux gouvernés.
Mesurer la qualité d’un RAG : métriques, tests, et gestion des erreurs
Un RAG se mesure à deux étages : récupération et génération. Pour la récupération, on utilise des métriques comme Recall@k (le bon passage est-il dans les k premiers), MRR (Mean Reciprocal Rank, pour savoir si le bon passage arrive tôt), ou nDCG (qualité du classement quand plusieurs passages sont utiles). Le piège est de n’évaluer que sur des questions simples. Construisez un jeu de test avec les cas pénibles : exceptions, versions, documents contradictoires, termes internes ambigus. Un bon signal opérationnel est le taux de sessions où l’utilisateur clique sur la source citée, ou reformule la question.
Pour la génération, les métriques doivent refléter le risque. Dans un assistant interne, une réponse élégante mais fausse est pire qu’un « je ne sais pas ». On évalue donc la fidélité aux sources (faithfulness) : la réponse est-elle supportée par les extraits fournis. On ajoute des tests de refus : quand les passages retrouvés sont insuffisants, le modèle doit demander une précision ou dire qu’il ne trouve pas. Une méthode pragmatique consiste à annoter un échantillon de sessions (par exemple 200 par semaine au démarrage) avec trois labels simples : correct, incomplet, incorrect. Cela donne une trajectoire de qualité.
Pour rendre ces mesures actionnables, une taxonomie d’erreurs “utile” (et pas trop lourde) est :
- R0 – Rien trouvé : retrieval vide ou hors-sujet (souvent un problème de filtres, de langue, ou de chunking).
- R1 – Mauvaise source : passage pertinent mais périmé / mauvais pays / mauvais produit (métadonnées, versioning).
- G0 – Hallucination : la réponse introduit un fait non présent dans les extraits (garde-fous, consignes de citation).
- G1 – Réponse trop générale : extraits corrects mais synthèse imprécise (reranking, top-k, prompt de synthèse).
- UX – Mauvaise utilisabilité : réponse correcte mais inutilisable (pas de lien, pas d’étapes, pas de contact, pas de “prochaine action”).
En production, instrumentez. Loggez la question, les documents récupérés, les scores, la version du prompt, et la réponse. Ajoutez des alertes : hausse des « no answer », baisse des scores de retrieval, augmentation des requêtes sur des documents obsolètes. Et faites des tests A/B de prompts et de stratégies de retrieval, comme vous le feriez pour un moteur de recherche. Cette approche data-driven est souvent plus rentable qu’un entraînement : on améliore la qualité en ajustant le pipeline (chunking, filtres, reranker) avant de toucher au modèle.
Enfin, gardez un œil sur des indicateurs “production” qui parlent aux équipes IT :
| Indicateur | Pourquoi c’est critique |
|---|---|
| Temps de réponse p95 | Conditionne l’adoption (surtout support/ops) |
| Taux de réponses avec citation cliquable | Proxy de traçabilité et de confiance |
| Part des requêtes filtrées par ACL | Vérifie que les contrôles d’accès sont réellement appliqués |
| Taux de refus (“je ne sais pas”) | Trop faible = risque d’hallucination ; trop élevé = retrieval à corriger |
| Top sources consultées | Met en évidence les sources “piliers” à gouverner en priorité |
Sécurité et conformité : protéger les documents, contrôler l’exfiltration, auditer
Le RAG manipule des données internes. Avant même de parler modèles, commencez par classifier les informations et leurs flux. Quelles sources contiennent des données personnelles, des secrets, des informations réglementées. Quelles applications les transportent. L’objectif est double : éviter d’indexer ce qui ne doit pas l’être, et appliquer des contrôles cohérents. L’article Classification des données : cartographier flux sensibles par application et réseau fournit une méthode concrète pour cette étape. Le principe est simple : minimisation, besoin d’en connaître, et journalisation.
Ensuite, sécurisez l’accès aux documents au niveau le plus fin possible. Un RAG « interne » n’est pas un RAG « tout le monde voit tout ». Les contrôles doivent s’appliquer au retrieval : filtrer l’index par droits d’accès de l’utilisateur (ACL documentaires), puis seulement chercher dans cet espace autorisé. Sans cela, le modèle devient un accélérateur de fuite.
Mesures concrètes (souvent nécessaires dès la V1) :
- Isolation des tenants / environnements (dev/test/prod) et séparation des index.
- Filtrage ACL côté retrieval (pas uniquement côté UI) : l’utilisateur ne doit jamais récupérer un chunk qu’il n’est pas censé lire.
- Réduction du contexte : n’envoyez au LLM que les passages nécessaires (principe de minimisation).
- Redaction / masquage de certains champs (PII, identifiants internes) dans les logs applicatifs.
- Politiques de rétention : durée de conservation des requêtes, des contextes envoyés au LLM, et des réponses (et qui y accède).
Ajoutez aussi des protections contre l’injection de prompt et l’exfiltration. OWASP rappelle que les applications LLM doivent être conçues comme des systèmes exposés à des attaques applicatives classiques plus des vecteurs spécifiques (voir le projet OWASP Top 10 for LLM Applications : https://owasp.org/www-project-top-10-for-large-language-model-applications/). Concrètement : séparez les rôles, interdisez au modèle d’exécuter des actions sensibles sans validation, et filtrez les sorties (par exemple détection de secrets et PII).
Enfin, traitez vos fournisseurs et vos modèles comme des actifs à auditer. Qui opère l’infrastructure, où sont stockées les données, quelles clauses de confidentialité, quels logs, quels sous-traitants. Le niveau d’exigence dépend de vos données, mais la check-list doit être systématique. Pour structurer cette démarche, vous pouvez vous appuyer sur Audit fournisseurs : check-list en 8 étapes pour sécuriser la conformité.
Contexte France/UE : selon vos cas d’usage, vous pouvez aussi devoir vous aligner sur des exigences réglementaires spécifiques (ex. RGPD pour les données personnelles ; exigences sectorielles ; et, plus largement, obligations applicables aux systèmes d’IA selon leur usage). Pour un repère textuel officiel sur le cadre européen, le règlement “AI Act” est accessible sur EUR-Lex : https://eur-lex.europa.eu/eli/reg/2024/1689/oj. L’objectif, côté RAG, est surtout de prouver : quelles données entrent, quels contrôles s’appliquent, quelles traces existent, et comment vous gérez les incidents (accès, fuites, réponses erronées à fort impact).
Enfin, gardez une définition opérationnelle de la confiance : le NIST AI Risk Management Framework décrit les caractéristiques attendues de systèmes d’IA “trustworthy” (validité/fiabilité, sécurité/résilience, transparence/responsabilité, explicabilité, protection de la vie privée, équité), utile comme grille d’audit interne : https://www.nist.gov/itl/ai-risk-management-framework.
ROI du RAG : modèle de coûts, délais réalistes, et indicateurs de valeur
Le ROI d’un RAG se calcule mieux comme un portefeuille d’effets que comme une promesse globale. Côté coûts, séparez : (1) build initial (ingestion, sécurité, UX, évaluation), (2) run (inférence LLM, requêtes de recherche, stockage, observabilité), (3) maintenance (réindexation, gestion des versions, jeux de tests, revues sécurité). Ordres de grandeur usuels en organisation : un POC cadré peut tenir en 3 à 6 semaines si les sources sont propres et accessibles, mais l’industrialisation prend souvent 2 à 4 mois à cause des droits d’accès, des intégrations et de la conformité. Le poste le plus sous-estimé est le nettoyage documentaire et la gouvernance des sources.
Pour rendre la discussion “ROI” plus factuelle, vous pouvez poser un modèle simple de coûts récurrents (à adapter) :
| Poste | Exemple de variable qui fait varier la facture | Ce qui le fait baisser |
|---|---|---|
| Inférence LLM | volume de sessions, longueur des contextes | meilleur retrieval (top-k plus petit), réponses plus courtes, cache |
| Recherche (lexicale/vectorielle) | nombre de chunks / index, reranking | déduplication, filtrage en amont, index par domaine |
| Observabilité & logs | niveau de traçabilité exigé, rétention | politiques de rétention, masquage, sampling intelligent |
| Maintenance corpus | fréquence des changements, qualité des sources | gouvernance des owners, processus de publication/archivage |
Pour mesurer la valeur, prenez des métriques métier. Exemple service client : taux de déflexion (tickets évités), AHT (Average Handle Time), taux de résolution au premier contact, qualité perçue, et taux d’escalade vers un expert. Exemple support interne IT : temps moyen pour trouver une procédure, nombre d’incidents récurrents, respect des processus.
Un mini cas réaliste : une ETI avec 40 agents support, 12 000 demandes/mois, coût complet 12 € par demande. Si un RAG fiable réduit l’effort de 15 % sur 30 % des demandes (guidage, liens directs, formulaires pré-remplis), l’économie théorique est 12 000 × 0,30 × 0,15 × 12 € ≈ 6 480 €/mois. Il faut ensuite retrancher le coût d’exploitation (inférence, stockage, supervision) et surtout vérifier que la qualité ne se dégrade pas. Le ROI n’est donc pas automatique. Il se prouve par pilote instrumenté.
- Taux d’auto-résolution assistée : l’utilisateur arrive au bon document/process sans escalade, avec preuve (clic sur source, action effectuée).
- Baisse des erreurs opérationnelles : par exemple, diminution des tickets “mauvaise procédure appliquée” ou des retours qualité (quand vous avez un historique).
Il existe aussi des cas où le RAG n’est pas le bon investissement. Si vos documents sont peu structurés, contradictoires, ou non maintenus, vous allez surtout automatiser la confusion. Si le besoin est de produire des sorties très normalisées (par exemple des comptes rendus au format interne) et que l’information est déjà dans un SI structuré, un connecteur vers des données structurées ou un workflow classique peut être plus fiable. Et si la question est essentiellement « parler comme nos experts », un fine-tuning léger via LoRA (Low-Rank Adaptation, technique d’adaptation de couches avec peu de paramètres) ou QLoRA (variante quantifiée pour réduire mémoire et coût) peut apporter plus de valeur. Le choix est donc un arbitrage entre coût, délai, risque et bénéfice.
Mise en œuvre en 6 semaines : livrables, garde-fous, et première étape concrète
Une trajectoire pragmatique commence par un cadrage serré, pas par un choix de modèle. Semaine 1 : (1) définir 3 à 5 parcours utilisateur, (2) lister 50 questions réelles, (3) identifier les sources autorisées, (4) fixer les critères de succès. Semaine 2 : construire un pipeline minimal d’ingestion sur une seule source bien tenue et mettre en place les logs. Semaine 3 : mettre en place l’évaluation retrieval et génération avec un jeu de tests annoté. Semaine 4 : intégrer les contrôles d’accès et les filtres, puis refaire les mesures. Semaine 5 et 6 : UX, monitoring, revue sécurité, et pilote avec utilisateurs.
Pour éviter une dérive “POC démo”, vous pouvez formaliser dès la semaine 1 quelques garde-fous simples :
- Périmètre documentaire explicite : ce qui est “dans” et “hors” corpus (et donc ce que l’assistant a le droit de traiter).
- Politique de refus : dans quels cas l’assistant doit répondre “je ne sais pas” et rediriger (ex. sujets RH sensibles, médical, juridique client…).
- Obligation de source : pas de réponse “affirmative” sans citation, au moins sur les sujets à risque.
- Canal de correction : comment un expert remonte une incohérence (et comment elle est corrigée dans la source, puis propagée via réindexation).
Les livrables qui évitent les discussions sans fin sont simples. Une carte des sources avec propriétaire, fréquence de mise à jour et niveau de sensibilité. Une politique de chunking documentée et versionnée. Un tableau de métriques avec seuils : Recall@5, taux de refus acceptable, taux de réponses sans citation, temps de réponse p95, et volume de documents indexés. Un registre des risques et des décisions, aligné avec votre gouvernance. Sur ce point, réutilisez les pratiques de registre, d’audit et de cycle de vie décrites dans le registre et le cycle de vie en gouvernance IA.
Astuce opérationnelle : demandez un livrable “preuve” à la fin de chaque semaine, pas un discours :
- S1 : liste des 50 questions + critères de succès signés
- S2 : 1 source ingérée + 1 index consultable + 1 page de traçabilité (doc → chunks)
- S3 : dashboard d’évaluation sur le jeu de test (retrieval + génération)
- S4 : démonstration des ACL (mêmes questions, deux profils, résultats différents)
- S5 : revue sécurité (risques + mesures) + monitoring p95
- S6 : pilote utilisateur + plan d’itération (top 10 erreurs + actions)
La première étape à lancer dès maintenant est volontairement non technique. Organisez un atelier de 90 minutes avec un représentant métier, un responsable data, un RSSI ou équivalent, et un propriétaire de la documentation. Objectif : sélectionner une source « propre » (par exemple une base de connaissances maintenue), choisir 50 questions, et classer la source selon votre politique (publique, interne, confidentielle, réglementée). Ensuite seulement, vous pourrez décider si un POC RAG est pertinent, et quelles contraintes de sécurité doivent être intégrées dès le départ. C’est ce cadrage qui déterminera le ROI, bien plus que le choix d’un modèle.