Table des matières :
- Ce que change l’IA dans la protection des données de santé
- Définir le périmètre : données de santé, données dérivées et traces d’usage
- Cartographier les flux de bout en bout : une méthode praticable en 2 à 4 semaines
- Cartographier les accès : qui peut voir quoi, quand et comment le prouver
- Conservation et effacement : maîtriser les logs, les embeddings, les sauvegardes et les jeux d’entraînement
- Arbitrer entre RAG, fine-tuning et entraînement sans exposer inutilement les données
- Pilotage et première étape : rendre la cartographie exploitable au quotidien
Ce que change l’IA dans la protection des données de santé
La protection des données de santé en IA ne se limite pas à sécuriser un dossier patient dans un SI classique. Un projet d’IA multiplie les points de contact avec les données : prompts saisis par les utilisateurs, pièces jointes, extraits de documents injectés dans un RAG, journaux techniques, jeux d’évaluation, environnements de test, exports pour annotation. Chaque étape crée un nouveau flux et souvent une nouvelle copie. Sans cartographie, on ne sait plus où se trouvent les données, qui les consulte ni combien de temps elles sont conservées.
Le besoin métier est généralement simple : aider un service client hospitalier à rédiger des réponses, assister un médecin dans la synthèse d’un compte rendu ou retrouver rapidement une procédure interne. La technologie peut varier, mais la question de conformité reste la même : quelles données sont nécessaires pour atteindre l’objectif, et lesquelles sont « juste pratiques » ? Le principe du RGPD est explicite. L’article 5, paragraphe 1, point c), impose la minimisation. Les données doivent être « adéquates, pertinentes et limitées à ce qui est nécessaire » au regard de la finalité (source : RGPD, Eur-Lex : consulter le règlement général sur la protection des données).
Ce que l’IA change, c’est aussi la granularité des échanges. Un chatbot interne peut recevoir un message qui mélange identité du patient, contexte clinique, information administrative et opinion d’un soignant. Ensuite, ce même message est :
- affiché dans l’interface ;
- transmis au backend ;
- éventuellement stocké comme conversation ;
- copié dans des logs applicatifs si une erreur survient ;
- réutilisé dans un jeu d’évaluation si l’équipe cherche à « mesurer la qualité ».
Un mini-scénario très réaliste : un agent d’accueil copie-colle une partie d’un compte rendu pour demander « Résume-moi ça en langage patient ». Le compte rendu contient un nom, une date de naissance et un numéro de dossier. Même si l’agent n’a « rien exporté », le projet a créé un flux de données de santé via le prompt, avec des traces possibles côté observabilité.
Autre différence majeure avec l’analytique traditionnelle : l’IA introduit des composants dont l’observabilité est imparfaite. Un modèle peut résumer correctement tout en divulguant un identifiant dans une trace, ou un outil peut conserver en cache des extraits de documents. Votre défense repose donc moins sur une confiance implicite dans le modèle que sur la maîtrise des flux, des accès et de la conservation. C’est précisément ce que permet une cartographie bien menée : transformer un sujet « abstrait » (conformité de l’IA) en contrôles concrets (où, qui, combien de temps, quelles preuves).
Définir le périmètre : données de santé, données dérivées et traces d’usage
En droit européen, les données de santé sont des données personnelles relevant des catégories particulières. Le RGPD définit les « données concernant la santé » comme des données relatives à l’état de santé physique ou mentale (article 4, paragraphe 15) et encadre leur traitement (article 9). Pour une équipe projet, la difficulté n’est pas la définition juridique, mais sa traduction opérationnelle. Un numéro de dossier, une date d’hospitalisation, un compte rendu PDF, mais aussi un texte libre saisi dans un chat peuvent contenir des informations de santé.
En pratique, pour cadrer le périmètre, vous gagnez du temps en distinguant trois niveaux (utile pour l’atelier de cartographie et pour l’AIPD/DPIA lorsqu’elle est requise) :
- Données de santé « évidentes » : comptes rendus, prescriptions, résultats d’examens, courriers médicaux, observations.
- Identifiants et quasi-identifiants : nom, NIR/INS, numéro de dossier, date de naissance, dates de passage, localisation (service, chambre), combinaison « rare » d’éléments.
- Contexte révélateur : service consulté (oncologie, psychiatrie), motif de consultation, spécialité, type d’acte — parfois déductibles même si le contenu est masqué.
Dans un pipeline IA, il faut aussi considérer les données dérivées. Exemples courants :
- Embeddings : représentations numériques (vecteurs) calculées à partir d’un texte pour faire de la recherche sémantique. Un embedding n’est pas « lisible » comme un PDF, mais il peut contenir de l’information et être ré-identifiable dans certains contextes. Par prudence, on le traite comme une donnée sensible.
- Extraits utilisés pour le RAG : paragraphes indexés et restitués au modèle. Ce sont souvent des morceaux de documents sources, donc des données de santé si la source en contient.
- Labels d’annotation : catégories ajoutées par des humains (ex. : pathologie, gravité, urgence). Ils peuvent révéler des informations médicales.
À ce stade, un point de méthode aide : documentez la transformation (ce qui est dérivé de quoi). Par exemple : « embedding X dérivé du chunk Y, lui-même dérivé du document Z ». Cette traçabilité simplifie ensuite la suppression complète (suppression du document → suppression des chunks → suppression des embeddings).
Troisième zone grise : les traces d’usage. Journaux d’API, logs applicatifs, métadonnées de requêtes, télémétrie. Même si le contenu est masqué, des métadonnées peuvent suffire à déduire des informations (ex. : service consulté, spécialité, fréquence de consultation). Avant de parler d’« entraînement », commencez par inventorier ces traces. Dans beaucoup de projets, réduire la durée de conservation des logs, désactiver la journalisation des payloads ou filtrer les prompts constitue la mesure la plus efficace à court terme.
Cartographier les flux de bout en bout : une méthode praticable en 2 à 4 semaines
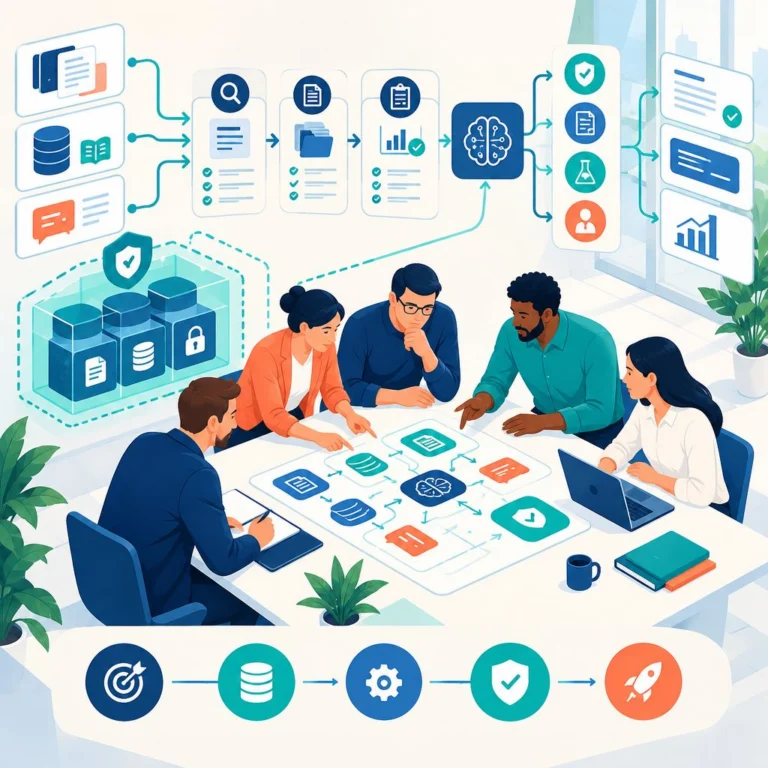
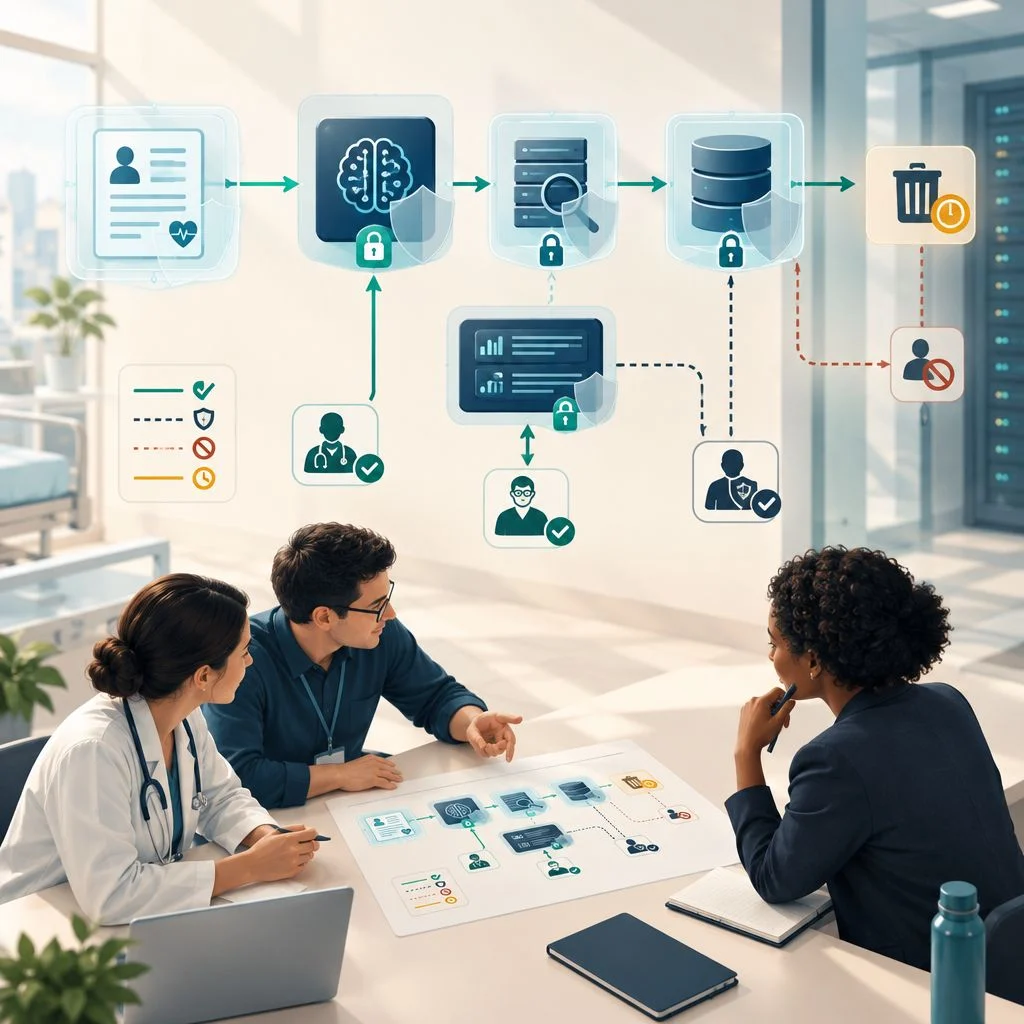
Cartographier les flux, ce n’est pas produire un schéma théorique. C’est décrire, pour un cas d’usage donné, le chemin réel des données depuis leur source jusqu’aux sorties, avec les copies intermédiaires. Une approche pragmatique consiste à faire un DFD (Data Flow Diagram) au niveau « ingénierie », puis à l’aligner avec le registre des traitements (article 30 du RGPD). Si vous n’avez pas de base, l’article interne sur la cartographie des flux sensibles donne un cadre utile : Classification des données : cartographier les flux sensibles par application et réseau.
Procédure concrète, à répéter pour chaque cas d’usage :
- Délimiter le périmètre : une application, un canal (web, Teams, mobile), une population d’utilisateurs.
- Lister les sources : DPI, GED, messagerie, bases métiers, fichiers partagés.
- Identifier les traitements : extraction, OCR, découpage en chunks, calcul d’embeddings, recherche, génération.
- Recenser les stockages : base documentaire, base vectorielle, cache, files de messages, sauvegardes.
- Qualifier les transferts : réseau interne, VPN, Internet, inter-régions cloud, sous-traitants.
Pour que la méthode tienne en 2 à 4 semaines, fixez des règles de cadrage simples :
- Un cas d’usage = une cartographie (pas « toute l’IA de l’hôpital »).
- Inclure la production et le hors-production (sinon, l’analyse est fausse).
- Tracer les artefacts temporaires : fichiers OCR, dumps de debug, exports CSV pour annotation.
- Noter la localisation (UE/hors UE, sur site/cloud, région) dès le premier jet : c’est souvent le déclencheur des actions correctrices (ex. : segmentation réseau, choix d’hébergement, clauses contractuelles).
Exemple typique en santé : un assistant interne basé sur le RAG. Les documents sont prétraités (OCR, découpage en chunks), indexés dans une base vectorielle, puis interrogés à chaque question utilisateur. Sans cartographie, on oublie souvent deux flux : les exports de debug (extraits de documents copiés dans un ticket) et les environnements hors production, où les index sont répliqués « pour tester ». Pour cadrer l’architecture et les points de contrôle (chiffrement, segmentation, audit), vous pouvez vous appuyer sur : RAG et recherche documentaire : architecture, sécurité et ROI pour les organisations.
Un livrable très opérationnel, et facile à relire par le DPO ou le RSSI, consiste à ajouter à votre DFD trois attributs pour chaque flux :
- Type de données (santé / identifiant / dérivé / log) ;
- Base légale et finalité (même sous forme courte) ;
- Mesures minimales (chiffrement en transit, chiffrement au repos, contrôle d’accès, durée).
Cartographier les accès : qui peut voir quoi, quand et comment le prouver
La cartographie des accès complète celle des flux. Deux questions doivent trouver une réponse sans ambiguïté : qui peut consulter les données (lecture), et qui peut les exporter ou les réutiliser (ex. : pour l’évaluation ou l’entraînement). Dans un environnement IA, les accès « indirects » comptent autant que les accès directs. Un développeur qui lit des logs applicatifs peut accéder à des prompts contenant des données de santé. Un data scientist qui télécharge un jeu d’évaluation accède à des conversations entières.
Un bon test de robustesse consiste à simuler deux incidents « sur papier » :
- Incident A (interne) : un compte admin est compromis. Quelles données l’attaquant peut-il extraire en 30 minutes (logs, exports, index vectoriel) ?
- Incident B (support) : un ticket de support contient un extrait de conversation avec des données de santé. Qui, côté IT ou éditeur, peut lire le ticket et ses pièces jointes ?
Techniquement, vous avez besoin d’un modèle d’habilitation explicite. Les mécanismes courants sont :
- RBAC (Role-Based Access Control) : droits par rôle (médecin, agent, admin).
- ABAC (Attribute-Based Access Control) : droits par attributs (service, établissement, niveau de sensibilité).
- JIT (Just-In-Time access) : droits élevés accordés temporairement, avec approbation.
Le minimum viable est RBAC + MFA + journalisation. Mais en santé, l’écart entre « accès utile » et « accès excessif » est vite critique, surtout pour les jeux de test. Deux précisions souvent oubliées :
- Séparer lecture, export et administration : « pouvoir administrer l’index » n’implique pas « pouvoir lire le contenu indexé ».
- Prouver : en audit ou en cas d’incident, il ne suffit pas d’affirmer « seuls les admins y ont accès ». Il faut être capable d’extraire des éléments de preuve (journaux IAM, logs d’accès aux buckets ou bases de données, traces SIEM).
La dimension fournisseur est souvent le point faible : API de modèle, hébergement, annotation, maintenance. Pour chaque sous-traitant, il faut pouvoir démontrer la chaîne de responsabilités, les lieux de traitement et les mesures de sécurité. La check-list interne aide à structurer l’évaluation : Audit fournisseurs : check-list en 8 étapes pour sécuriser la conformité. En France, la question HDS (Hébergement de Données de Santé) revient fréquemment. Vérifiez si votre scénario relève d’un hébergement pour compte de tiers, et documentez la décision, y compris pour les environnements de test si des données réelles y circulent. Référence utile : le site de l’Agence du numérique en santé.
Enfin, pensez « contrat + technique » : une clause interdisant la réutilisation des données par un sous-traitant est importante, mais elle doit être renforcée par des contrôles (désactivation de la conservation des prompts côté fournisseur quand c’est possible, chiffrement, cloisonnement et revue périodique des accès).
Conservation et effacement : maîtriser les logs, les embeddings, les sauvegardes et les jeux d’entraînement
La conservation est l’endroit où les projets IA « dérapent » sans s’en rendre compte. On conserve par défaut : logs applicatifs, traces d’observabilité, fichiers temporaires, caches, index, sauvegardes. Or le RGPD pose un principe de limitation. L’article 5, paragraphe 1, point e), exige que les données soient « conservées sous une forme permettant l’identification des personnes concernées pendant une durée n’excédant pas celle nécessaire » au regard des finalités (source : RGPD, Eur-Lex : consulter le règlement général sur la protection des données). Ce principe s’applique aussi aux copies techniques.
Une bonne pratique consiste à bâtir une matrice de conservation par type d’objet. Exemples de lignes typiques :
- Conversations utilisateur : conservation courte, avec masquage automatique des identifiants et exclusion explicite des logs système.
- Documents sources : conservation selon le référentiel métier (dossier patient, procédures internes), mais accès restreint.
- Index vectoriel : conservation alignée sur celle des documents sources, avec mécanisme de réindexation et de suppression.
- Jeux d’évaluation : conservation limitée, pseudonymisation forte, traçabilité des versions.
- Sauvegardes : durée et périmètre définis, et procédure de restauration testée.
Pour rendre la matrice directement actionnable, ajoutez deux colonnes qui « forcent » les décisions techniques :
| Objet | Durée cible (exemple à adapter) | Stockage(s) | Mécanisme d’expiration | Responsable | Risque principal |
|---|---|---|---|---|---|
| Logs applicatifs (sans payload) | 30–90 j | SIEM/observabilité | TTL / rotation | RSSI/IT | corrélation indirecte |
| Prompts / payloads (si conservés) | 0–30 j | base conversation | purge + masquage | Produit | fuite de données de santé |
| Embeddings | alignée sur la source | DB vectorielle | purge par document + réindexation | Data/IT | effacement incomplet |
| Exports de debug / tickets | 0–30 j | outil ITSM | règles + revue | Support | partage non maîtrisé |
| Jeu d’évaluation | 3–6 mois | bucket chiffré | TTL + revue | Data/QA | réutilisation secondaire |
Les durées ci-dessus sont volontairement illustratives : l’objectif est d’obtenir une durée explicite et un mécanisme effectif, pas seulement de dire « on supprimera un jour ». Dans beaucoup d’organisations, la première avancée en matière de conformité n’est pas « la politique parfaite », mais la mise en place de TTL, de rotation et d’une purge vérifiable.
La difficulté opérationnelle est l’effacement réel. Supprimer un PDF ne supprime pas son embedding, ni les extraits stockés dans un cache, ni la copie dans une sauvegarde. Il faut donc définir la « suppression complète » comme un processus. Étapes typiques : suppression dans le stockage primaire, purge de l’index, invalidation des caches, puis gestion des sauvegardes selon leur cycle (souvent par expiration).
Checklist simple pour vérifier que l’effacement est « complet » dans un projet IA :
- le document source est supprimé ou rendu inaccessible ;
- tous les chunks dérivés sont supprimés ;
- tous les embeddings associés sont supprimés ou recalculés ;
- les caches applicatifs sont purgés ;
- les exports de debug et les jeux de données temporaires sont supprimés ;
- la suppression est traçable (journal d’opération, ticket, preuve).
Pour les données sensibles, documenter une stratégie de chiffrement avec rotation des clés aide. Détruire une clé de chiffrement ne remplace pas une politique de rétention, mais c’est une barrière additionnelle utile, notamment pour réduire l’impact d’une fuite de sauvegarde.
Arbitrer entre RAG, fine-tuning et entraînement sans exposer inutilement les données
Beaucoup d’équipes pensent qu’il faut entraîner un modèle pour qu’il connaisse leur métier. En pratique, l’entraînement n’est pas toujours la bonne réponse, surtout avec des données de santé. Relier un modèle existant à vos documents avec un RAG (Retrieval-Augmented Generation) suffit souvent. Le RAG consiste à rechercher des passages pertinents dans une base documentaire (via des embeddings), puis à les fournir au modèle au moment de répondre. Avantage : vous réduisez la nécessité d’injecter des données de santé dans les poids du modèle, ce qui simplifie la gouvernance des suppressions et des droits.
Un critère de décision très concret : demandez-vous si la connaissance à apporter au système relève principalement :
- de contenus qui changent (procédures, référentiels internes, courriers types, annuaires) → le RAG est généralement plus adapté ;
- de comportements (format de réponse, extraction structurée, ton, logique de tri) → le fine-tuning peut aider ;
- d’une compétence « générale » nécessitant beaucoup d’exemples → l’entraînement complet devient un sujet, rarement justifié avec des données de santé en dehors d’acteurs spécialisés.
Le fine-tuning est différent. Il ajuste un modèle existant sur vos exemples pour modifier son comportement (style, format, procédures, extraction). Des techniques comme LoRA (Low-Rank Adaptation) ou QLoRA (version quantifiée, plus légère en mémoire) permettent d’adapter un modèle avec moins de ressources, mais elles ne suppriment pas les contraintes de confidentialité. Si vos exemples contiennent des données de santé, vous devez traiter ces jeux de données comme des actifs hautement sensibles, avec contrôle d’accès et durée de conservation définie. Pour cadrer le choix, voir : Fine-tuning LLM : choisir RAG, LoRA ou QLoRA selon l’usage.
Point d’attention souvent sous-estimé : même sans entraîner le modèle, vous pouvez exposer des données si :
- vous envoyez au modèle des extraits trop longs (principe de minimisation non respecté) ;
- vous ne filtrez pas les identifiants dans les prompts ;
- vous conservez des conversations complètes « pour améliorer le produit » sans finalité précise.
Enfin, l’entraînement complet (pré-entraînement ou post-entraînement lourd) est le plus coûteux et le plus long. Il demande des volumes importants, une expertise ML avancée et une gouvernance très stricte des données. Les ordres de grandeur sont parlants : un RAG bien cadré peut se concevoir en 2 à 6 semaines (surtout si les documents sont déjà structurés), alors qu’un fine-tuning bien mené demande souvent plusieurs semaines de préparation des données et d’évaluation. L’entraînement complet se compte plutôt en mois, avec une facture d’infrastructure et des risques réglementaires plus élevés. Pour comprendre les phases et les livrables attendus : Entraînement LLM : étapes clés du pré-entraînement au post-entraînement.
Dans tous les cas, commencez par une règle simple : aucune donnée de santé dans un jeu d’entraînement tant que la base légale, la minimisation et la durée de conservation ne sont pas actées, et tant que les données n’ont pas été pseudonymisées ou anonymisées selon une méthode validée. En pratique, cela implique aussi de trancher en amont : « ce cas d’usage nécessite-t-il vraiment des données réelles, ou peut-on démarrer avec des données synthétiques, des gabarits ou des documents non cliniques ? »
Pilotage et première étape : rendre la cartographie exploitable au quotidien
Une cartographie utile est une cartographie vivante. Elle se connecte à la gouvernance du projet : registre des modèles, versions de prompts, jeux de tests, audits de sécurité, suivi des incidents. L’objectif n’est pas de produire un document « pour l’audit », mais d’avoir une base pour arbitrer. Exemple : ajouter une nouvelle source documentaire au RAG. La cartographie permet de dire immédiatement quels flux changent, quels accès doivent être ouverts et quelles règles de conservation s’appliquent.
Pour éviter que la cartographie ne devienne un PDF figé, rattachez-la à des événements de vie du produit :
- mise en production d’un nouveau connecteur (nouvelle source) ;
- changement de fournisseur (API, hébergement, annotation) ;
- ouverture à une nouvelle population d’utilisateurs ;
- ajout d’un jeu d’évaluation ou d’un dispositif d’observabilité ;
- incident, même mineur, lié à une fuite de prompt ou à un export.
Pour piloter, définissez quelques indicateurs simples et vérifiables :
- Couverture de cartographie : pourcentage des composants IA (application, API, index, logs, sauvegardes) décrits avec un propriétaire et une localisation.
- Délai de révocation : temps moyen nécessaire pour retirer un accès sensible (compte, clé API, rôle admin).
- Conformité de rétention : proportion des stockages ayant une durée et un mécanisme d’expiration effectifs.
- Traçabilité : capacité à répondre en moins de 48 h à la question « quelles données ont été utilisées pour produire telle réponse ? » (utile pour le support, les incidents et l’audit).
Astuce pragmatique : pour la traçabilité, cherchez un niveau « suffisant » plutôt que parfait. En RAG, par exemple, être capable de restituer la liste des documents et des chunks cités ainsi que la conversation (éventuellement masquée) constitue déjà un gain majeur pour l’investigation et le contrôle.
Pour structurer ce pilotage, l’article suivant sert de référence interne : Gouvernance de l’IA : registre de modèles, audits et cycle de vie. Et, si vous voulez relier cartographie et mesures techniques (segmentation, zones de confiance, chemins réseau), vous pouvez aussi vous appuyer sur ce rappel méthodologique : cartographier les flux sensibles par application et réseau.
Première étape concrète à réaliser cette semaine : organisez un atelier de 90 minutes sur un seul cas d’usage, pas sur tout le SI. Sortez avec deux livrables d’une page chacun : 1) un DFD simplifié listant les sources, les traitements, les stockages, les transferts et les environnements (production et hors production) ; 2) une table de conservation par objet (conversations, documents, embeddings, logs, sauvegardes) avec une durée cible et un responsable. Tant que ces deux pages ne sont pas stables, l’entraînement d’un modèle ou l’ouverture d’un accès fournisseur est, dans la plupart des organisations, prématuré.